 JR ACADEMY · SYSTEM DESIGN LABAI Engineering System Design
AI Engineering System Design
20 个主题,从 enterprise Agent platform 一路讲到 RAG、durable workflow、tool sandbox、GPU serving 与 AI governance。
START HEREAI Engineering System Design如何阅读这本书
这 20 个主题没有套用同一种分析模板。每章先识别真正的设计问题,再选择最适合的表达:Architecture Map、Sequence、Pipeline、Lifecycle、State Machine、Decision Tree、Ownership Map 或 Evaluation Gate。
先定义问题
说明真实场景、用户、数据、风险、功能要求与 NFR,不从产品名称或组件清单开始。
再选择正确的图
在线调用画 Request Path;长任务画 State Machine;知识系统画 Ownership 或 Index/Query 双轨;发布系统画 Gate 和 Feedback Loop。
最后做工程判断
检查 state owner、边界、失败恢复、扩容瓶颈和最接近的替代方案,再决定如何上线验证。
CONTENTSAI Engineering System Design目录
20 TOPICSAI Engineering System Design20 个主题分成四类
Part I · 平台与交付
统一 AI 入口、Agent Runtime、发布流程和工程交付。
- 企业级 Agentic AI 参考架构
- 生产级 AI 应用闭环
- 企业级 Agent 开发生命周期
- AI-Driven Software Development Lifecycle
- Claude Code Agent 开发能力地图
- 生产级 AI Coding Agent
Part II · Context、知识与 Memory
管理模型调用所需的规则、企业知识、检索结果和长期 Memory。
- LLM Context Engineering
- 生产级 RAG 应用
- RAG 知识摄取与索引流水线
- GraphRAG 与企业知识图谱
- 企业级 AI Agent Memory
- Deep Research / Agentic Search
Part III · Runtime 与交互
让长任务、工具调用、多模型、GPU 和实时语音稳定运行。
- 耐久型 AI Agent 编排
- AI Agent 工具执行沙箱与审批
- 企业级 AI Gateway 与多模型路由
- 高可用 LLM 推理与 GPU 调度
- 实时 Voice AI Agent
- 多模态文档智能处理
Part IV · Trust 与治理
保护租户数据,并通过评测、审批、审计和告警控制风险。
- 多租户 AI 数据隔离与隐私
- 生产级 AI Agent 评估、安全与治理
 AI ENGINEER 职业发展群微信交流群 · 顾问邀请入群讨论求职方向、项目经验与面试准备扫码添加顾问 · jiangren.com.au/contact申请入群 →
AI SYSTEM DESIGN REVIEWAI Engineering System Design
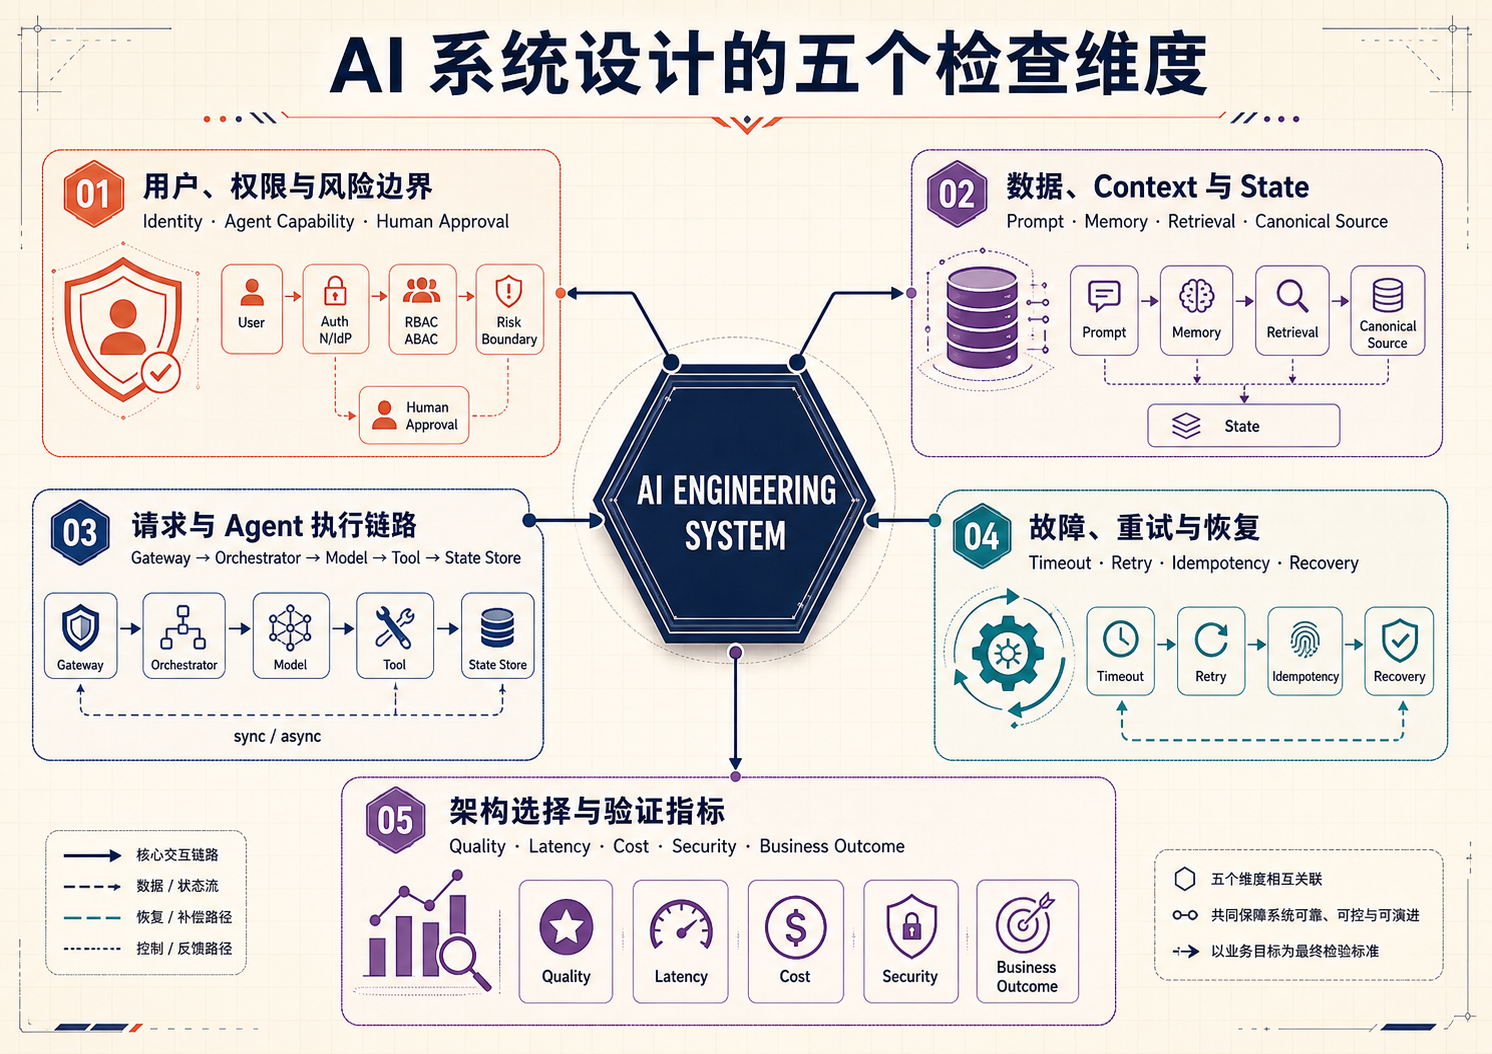 PLATFORMAI Engineering System Design
企业级 Agentic AI 参考架构
统一管理多个 Agent 的身份、数据、工具、审批和运行状态
一家企业要让客服、销售和运营 Agent 共用模型与工具,但不同部门的数据权限、预算和审批规则不能互相穿透。系统需要从试点扩展到多个业务域,同时保留人工接管能力。
系统需要提供什么
- 用户可以发起任务、查看进度,并在高风险动作前批准或拒绝。
- Agent 能检索企业知识、调用已登记工具,并把结果连同证据返回。
- 平台管理员可以管理 model、prompt、tool、policy 和 tenant 配置。
性能、安全与可靠性要求
- 每次 tool call 都要绑定 actor、tenant、purpose 和 policy decision。
- 长任务可以暂停、恢复和取消,重复执行不能重复产生副作用。
- 关键路径必须有 trace、cost、quality 与安全审计记录。
ARCHITECTURE MAPAI Engineering System Design企业级 Agentic AI 参考架构
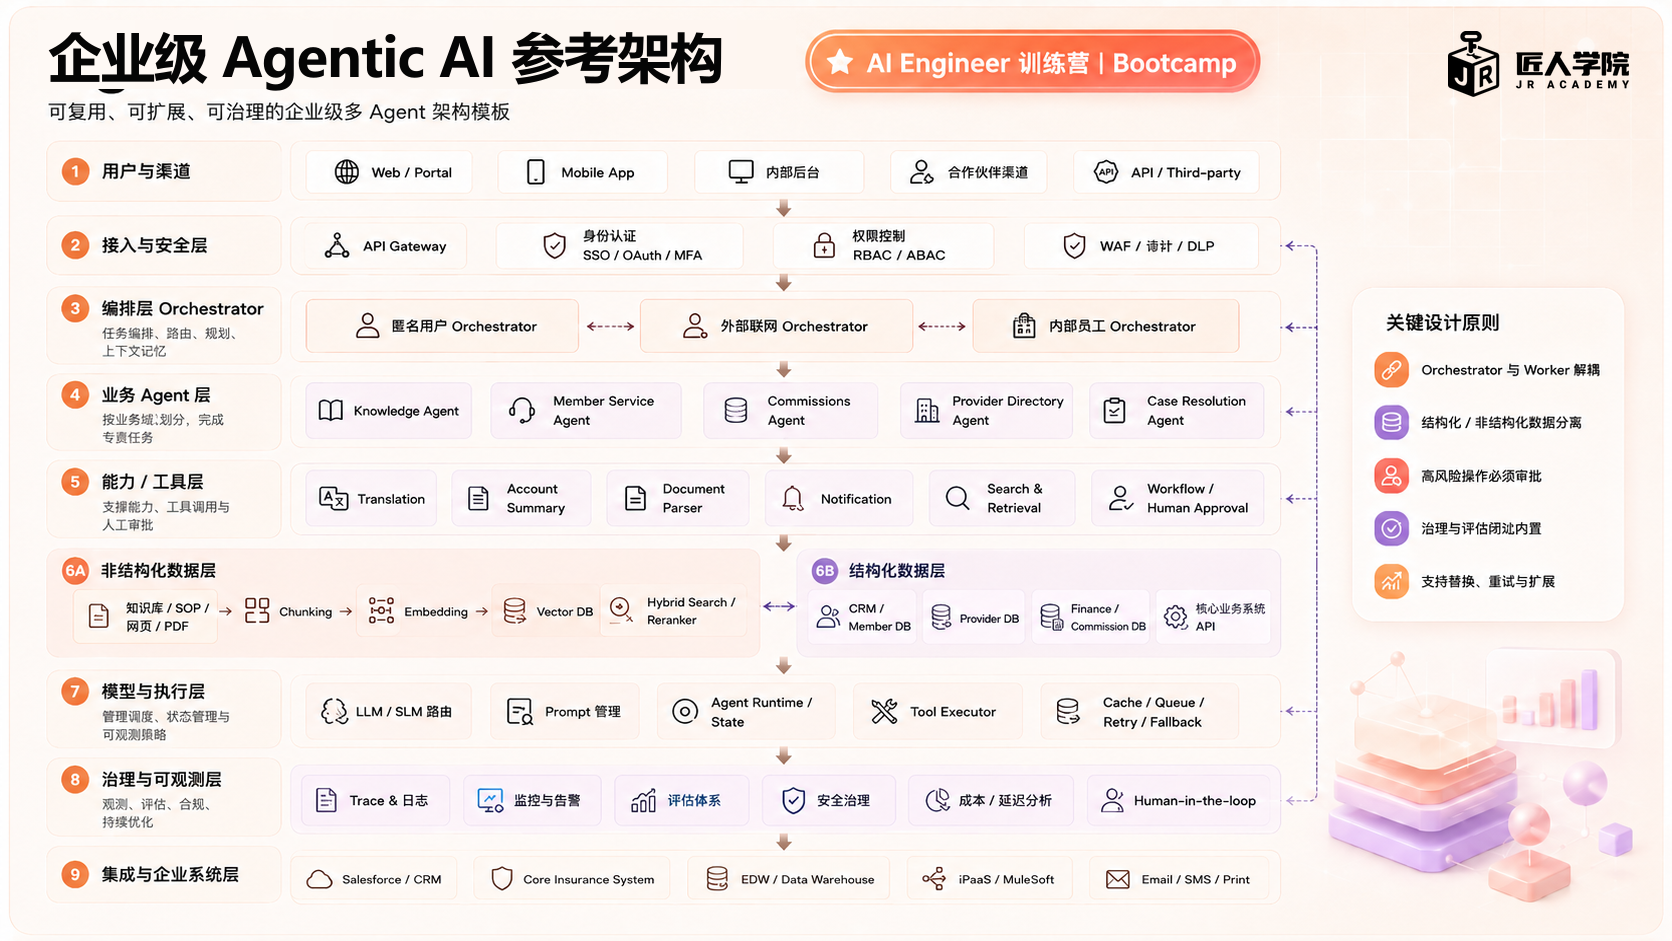 CONTROL PLANE · EXECUTION PLANE · TRUST BOUNDARYAI Engineering System Design
先分清谁制定规则,谁执行任务,谁守住边界
配置与治理
配置经过 review 后形成不可变 release;运行时固定读取该版本,不直接使用正在编辑的 draft。
登记 tool contract、可访问范围、副作用等级以及需要人工确认的操作。
候选版本通过质量、安全和回归检查后才能发布,并把 Model、Prompt、Workflow 与 Policy 作为一组回滚。
在线任务执行
Gateway 验证身份、tenant 和配额;Orchestrator 选择已发布的 workflow,并创建唯一 run ID。
按 ACL 读取 Prompt、Memory 与 Retrieval Evidence,同时记录本次实际使用的 Context IDs 和模型版本。
调用工具前再次授权;每一步结果和 side effect 先写入 checkpoint,再返回结果或 pending approval。
每次越界都重新授权
每次跨服务或访问数据时重新检查真实调用者、企业范围和用途,不能相信 Prompt 自己声明的身份。
Tool Gateway 只为一次动作签发最小权限、短期有效的凭证,过期后必须重新授权。
删除、付款、发布等操作绑定准确参数和过期时间;参数发生变化后,原批准自动失效。
 AI ENGINEER BOOTCAMP扫码或点击打开课程页面把 RAG、Agent、MCP、Memory 与 Governance 接成能上线的 Production Agentjiangren.com.au/program-course/ai-engineer-bootcamp查看课程 →
PROS, CONS & FAILURESAI Engineering System Design
方案的优点、限制与故障处理
方案的优点与缺点
- 集中管理的优点是权限、模型和工具规则更统一;缺点是平台一旦故障会影响多个业务,因此需要跨地区部署和故障隔离。
- 共享平台可以减少重复开发;但客服、销售等业务规则仍应分别维护,否则规则会越来越难修改。
- Agent 可以自主完成更多步骤,用户操作更少;相应地,系统必须收紧权限和预算,并让高风险操作经过人工确认。
常见故障及处理方法
- 统一入口不可用:只读、低风险功能可以使用备用入口;写数据或付款等高风险操作直接暂停。
- 模型拿到了错误资料:停止使用受影响的数据源,恢复上一版索引和 Prompt,再重新检查相关回答。
- 工具调用结果不确定:先查询目标系统确认操作是否成功,无法确认时交给人工处理,不能直接重试。
上线后要监控的指标
分别观察各企业和各类任务的排队长度;高流量业务使用独立的执行资源。
分别统计入口检查、资料检索、模型生成、工具调用和结果保存的耗时。
记录模型 Token、资料检索、工具调用、失败重试、数据存储和人工审核的费用。
检查权限是否足够小、凭证是否短期有效、高风险操作是否经过再次确认。
用同一个请求编号串起任务路由、使用资料、工具决定、执行进度、最终结果和用户反馈。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- 为什么 control plane 与 execution plane 要分开?
- Agent runtime 挂掉以后从哪里恢复?
- 如何防止一个 tenant 的 prompt 或 memory 泄漏给另一个 tenant?
- 哪些动作必须 human-in-the-loop?
提交设计前的检查清单
- 标出 canonical state owner。
- 每个外部调用都有 timeout、retry owner 和 idempotency key。
- 高风险动作 fail closed。
- 模型、prompt、policy、tool schema 都有 version。
- 结果可以追溯到 source 与执行记录。
PLATFORMAI Engineering System Design生产级 AI 应用闭环
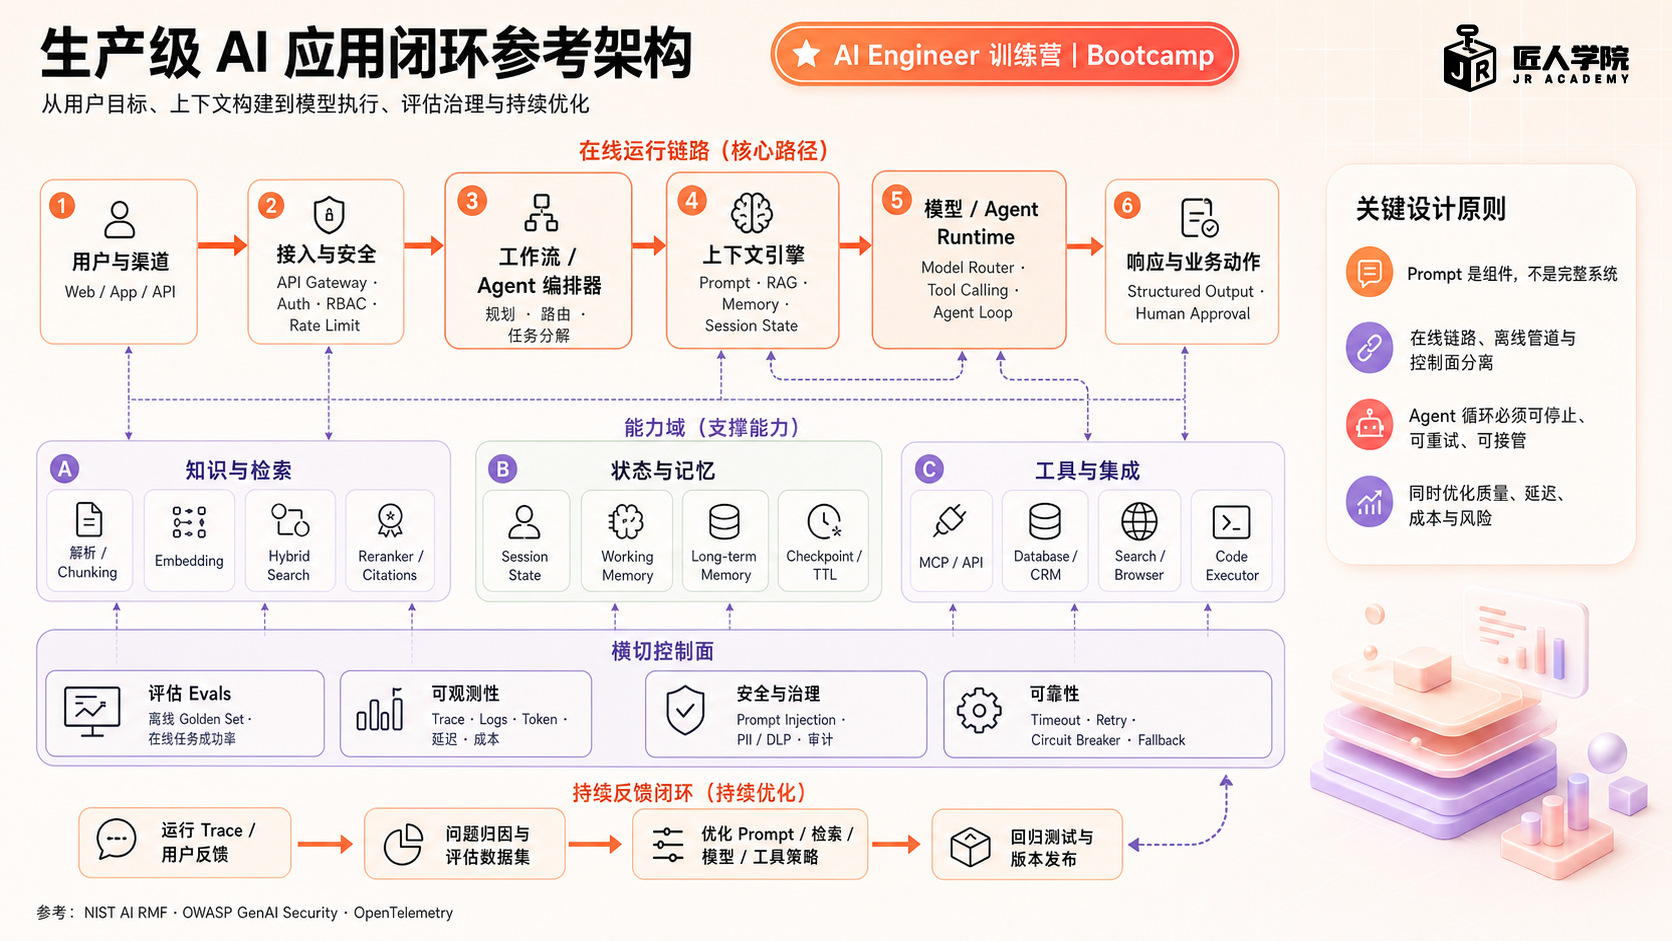
用监控、评测、灰度发布和回滚持续改进 AI 应用
一个 AI assistant 已有 demo,但没人能回答质量变差是 model、prompt、retrieval 还是数据漂移造成的。团队需要把用户请求、evaluation、release 和 feedback 连成闭环。
系统需要提供什么
- 在线请求必须记录使用的 model、prompt、index 与 policy version。
- 离线 evaluation 能重放代表性样本和已知 failure slice。
- 新版本先经过 shadow 或 canary,再决定扩大流量或 rollback。
性能、安全与可靠性要求
- 用户数据进入 evaluation dataset 前要经过授权与去标识。
- release decision 必须可审计,不能只看单一平均分。
- 线上反馈不能直接改写 canonical prompt 或 memory。
ARCHITECTURE MAPAI Engineering System Design生产级 AI 应用闭环
 AI ENGINEER 职业发展群微信交流群 · 顾问邀请入群讨论求职方向、项目经验与面试准备扫码添加顾问 · jiangren.com.au/contact申请入群 →
EVALUATION & RELEASE FEEDBACK LOOPAI Engineering System Design
生产问题先变成测试,再决定是否发布新版本
记录失败请求、用户反馈、质量指标和安全事件;先去除个人信息,不能把原始对话直接用于训练。
人工确认问题、去重并标注预期结果,把代表性失败案例加入带版本的 Golden Set 或 Regression Set。
让 Candidate 和当前生产版本 Control 跑同一批案例,比较质量、安全、延迟和成本;没有 benchmark 就写暂无数据。
先用复制流量观察 Candidate,再只给少量真实用户;超过错误率、成本或安全阈值立即停止。
只有评测结果、业务验收和回滚方案都通过,才发布准确的 Model、Prompt、Index 与 Policy 版本组合。
上线后出问题先回滚并定位原因,再把该案例加入 Regression Set,确保下一版不会重复同类错误。
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 真实用户案例更能发现实际问题;缺点是需要处理隐私,而且活跃用户的反馈可能无法代表所有人。
- 用 LLM 自动评分可以快速覆盖大量案例;但评分标准必须固定,并定期用人工答案校准。
- 先让少量用户使用新版本可以降低事故影响;代价是新旧版本会同时运行,数据分析更复杂。
常见故障及处理方法
- 自动评分标准发生变化:锁定评分模型版本,并用人工确认过的案例重新校准。
- 恶意或错误反馈进入数据集:未经审核的反馈只放入隔离区,不能直接用于训练或写入 Memory。
- 小流量测试结果不可信:检查新旧版本的用户是否可比、流量是否分配正确,以及结果是否需要更长时间才出现。
上线后要监控的指标
评测任务与线上回答分开运行;数据量大时把评测案例分组并行处理。
线上只记录必要信息,复杂的重新评分和问题归因在后台完成。
分别记录每个候选版本使用的评测 Token、人工审核时间和实验资源。
评测数据使用与生产数据相同或更严格的访问权限和保留期限。
在同一页面查看回答质量、安全问题、响应时间、费用和业务结果。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- 什么样的 feedback 可以进入训练集?
- 如何比较 prompt change 与 model change?
- 何时使用 shadow,何时使用 canary?
- 回滚时 index 和 memory version 怎么处理?
提交设计前的检查清单
- 定义 success 与 harm metric。
- 保留固定 regression set。
- 按 failure slice 报告结果。
- release 有 owner 和 rollback trigger。
- 线上反馈经过审核后再进入数据闭环。
PLATFORMAI Engineering System Design企业级 Agent 开发生命周期
覆盖 Agent 从需求评估、开发、发布、运行到退役的完整流程
多个 team 同时开发内部 Agent。若没有统一 lifecycle,同一个 tool 会被重复接入,prompt 和 policy 无人负责,试验版本也可能长期留在 production。
系统需要提供什么
- Use case 先确认业务 owner、用户、允许动作和退出条件。
- 开发者可以在 sandbox 中组装 workflow、tool 和 test set。
- 平台支持 review、发布、监控、升级和 retire。
性能、安全与可靠性要求
- 开发、staging、production 的数据与凭证必须隔离。
- 每次发布都能还原 source、依赖、evaluation 和审批记录。
- 退役流程必须撤销 token、schedule、webhook 和 data access。
AI ENGINEER BOOTCAMP扫码或点击打开课程页面把 RAG、Agent、MCP、Memory 与 Governance 接成能上线的 Production Agentjiangren.com.au/program-course/ai-engineer-bootcamp查看课程 →
ARCHITECTURE MAPAI Engineering System Design企业级 Agent 开发生命周期
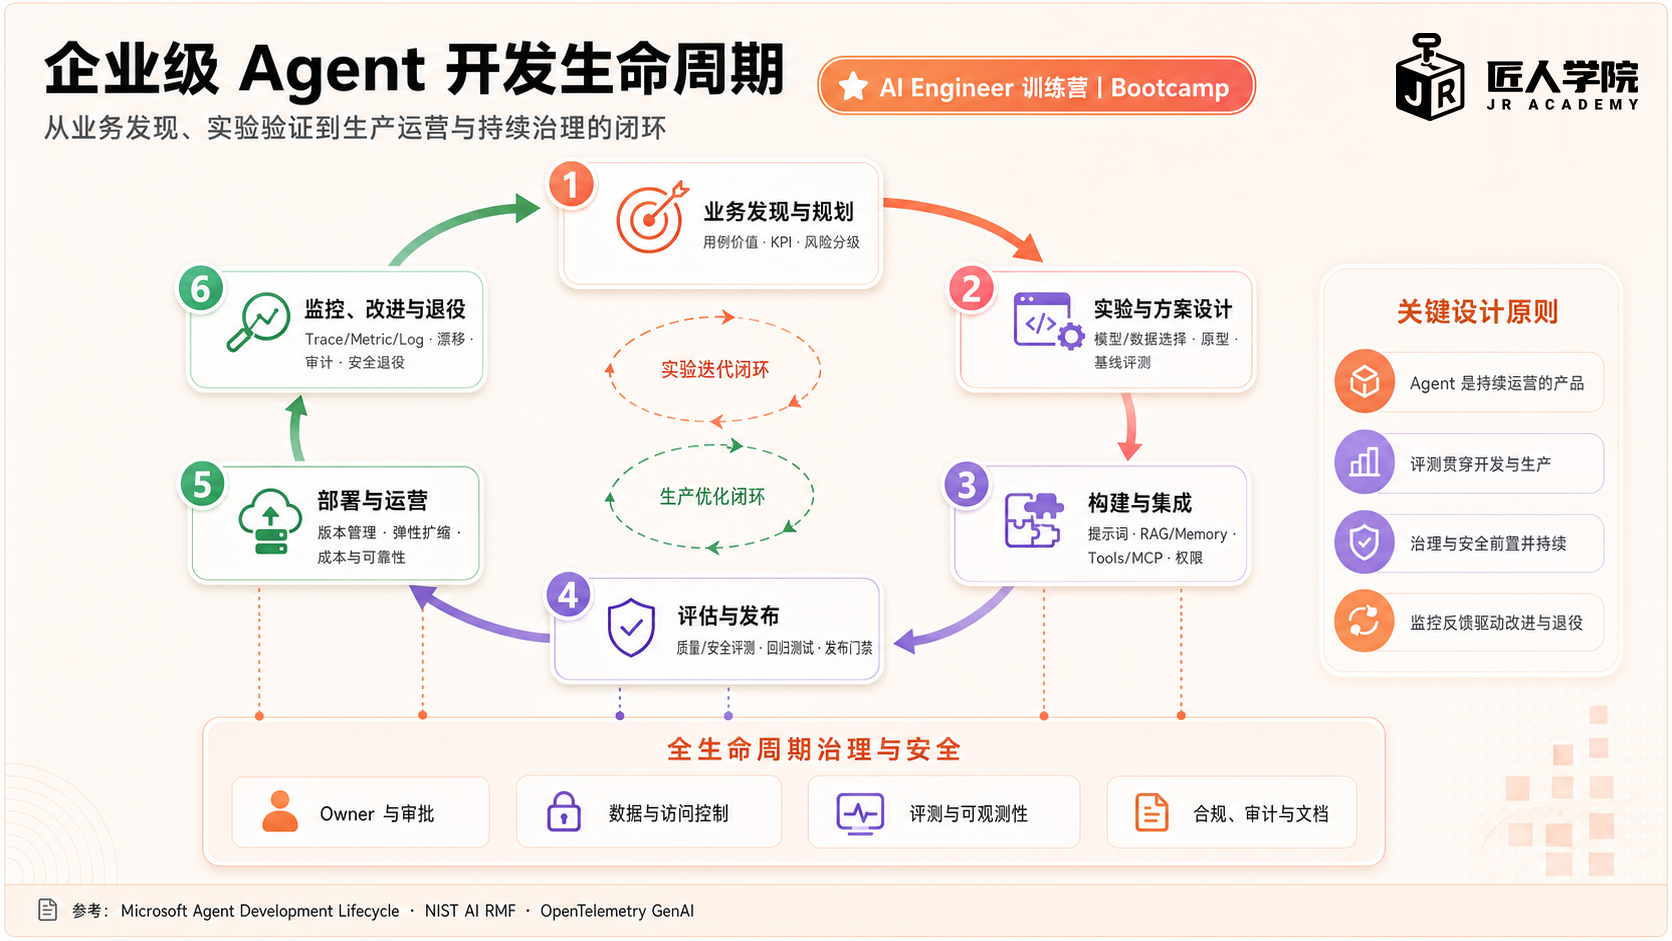 AGENT DEVELOPMENT LIFECYCLEAI Engineering System Design
Agent 从立项到下线,每一阶段都要有负责人和验收条件
交付:用途、目标用户、业务价值、风险等级和明确禁止的动作。
EXIT业务价值确认,并指定 Risk Owner。交付:State owner、数据分级、Tool scope、人工审批边界和故障恢复方案。
EXITArchitecture 与 Security Review 通过。交付:版本化 Prompt、Workflow、Connector、Eval hooks、Trace 和部署配置。
EXIT构建可复现,目标测试全部通过。交付:Candidate 对 Control 的 Eval、Red Team、UAT 结果和未解决风险清单。
EXIT门槛达标,剩余风险由 Owner 签收。交付:Canary 计划、Rollback、Version Bundle、Runbook、告警与值班负责人。
EXIT生产回读正常,指标保持在 Guardrail 内。交付:停止流量和定时任务、撤销凭证、按 Retention 删除数据与索引副本。
EXITDerived copy 与未完成任务核对清零,留下审计记录。PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 统一发布检查可以减少遗漏;但低风险改动不应和付款类 Agent 走同样复杂的流程。
- 平台模板能缩短开发时间;业务规则仍应由最了解业务的负责人维护。
- 自动评测可以拦住明显退步;是否符合业务要求仍需要业务负责人确认。
常见故障及处理方法
- 负责人离职或调岗:没有新负责人的 Agent 不能继续发布新版本。
- 外部系统接口发生变化:接口测试失败后暂停发布,先更新连接器。
- 无人使用但仍在运行:定期检查调用量、负责人、访问凭证和定时任务,确认是否应该停用。
上线后要监控的指标
按风险等级安排不同的测试和审批流程,避免所有 Agent 都走最重的流程。
发布管理服务只负责下发已批准配置,不加入每一次模型请求。
统计开发、维护、评测、人工审核、事故处理和最终停用的总成本。
检查开发、测试和生产环境是否隔离,依赖来源是否清楚,访问凭证是否定期更换。
按 Agent 和版本查看调用量、任务结果、故障记录和当前负责人。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- 什么证据足以从 staging 进入 production?
- 谁拥有 prompt、tool policy 与 evaluation dataset?
- 怎么发现长期无人维护的 Agent?
- 紧急修复如何既快又保留审计?
提交设计前的检查清单
- 有业务 owner 和 technical owner。
- 风险等级决定 gate。
- artifact、config、dataset 都有 version。
- 发布与 rollback 都可重复执行。
- retirement 是 lifecycle 的正式阶段。
AI ENGINEER 职业发展群微信交流群 · 顾问邀请入群讨论求职方向、项目经验与面试准备扫码添加顾问 · jiangren.com.au/contact申请入群 →
PLATFORMAI Engineering System DesignAI-Driven Software Development Lifecycle
让 AI 参与需求、编码、测试和 Review,同时保留工程控制
团队希望 AI 从需求澄清一路参与到 PR Review,但 issue、代码注释、依赖脚本和仓库文档都可能包含错误或恶意指令。Agent 必须在隔离环境内加速分析、修改和验证;需求取舍、高风险批准、Merge 与生产发布仍由工程团队负责。
系统需要提供什么
- 任务开始时固定 repository、base commit、允许修改的路径、可用工具和网络范围,并把需求写成可以测试的 Acceptance Criteria。
- Agent 只能读取当前用户获准访问的 issue、代码、文档和 CI 结果;仓库中的文字一律视为数据,不能覆盖系统权限或索取凭证。
- Agent 在独立 branch 或临时 worktree 中把工作拆成小步;涉及依赖升级、数据库迁移、安全策略或大范围改动时,先提交 proposal 等待确认。
- 每个完成声明都附带可审查的 diff、实际运行的命令、测试结果和 exit code;没有运行、超时或失败的检查必须明确标出。
- 最终通过 PR 交付改动摘要、关键设计决定、测试证据、未解决风险和 supply-chain provenance;Review、Merge 与 Release 权不交给 Agent。
性能、安全与可靠性要求
- 执行环境使用最小权限和短期凭证,不读取 production secret,也不能绕过 branch protection、required review 或 CI gate。
- 每个任务使用隔离 workspace、固定 base revision 和唯一 operation ID;失败、取消或重试不得覆盖开发者未提交的改动。
- 构建应能在干净环境复现,并锁定 dependency、toolchain、生成产物和来源;新增依赖必须经过许可证与漏洞检查。
- Audit log 连接 issue、计划、工具调用、文件修改、测试与 PR,同时对 token、credential 和敏感代码片段进行脱敏。
ARCHITECTURE MAPAI Engineering System DesignAI-Driven Software Development Lifecycle
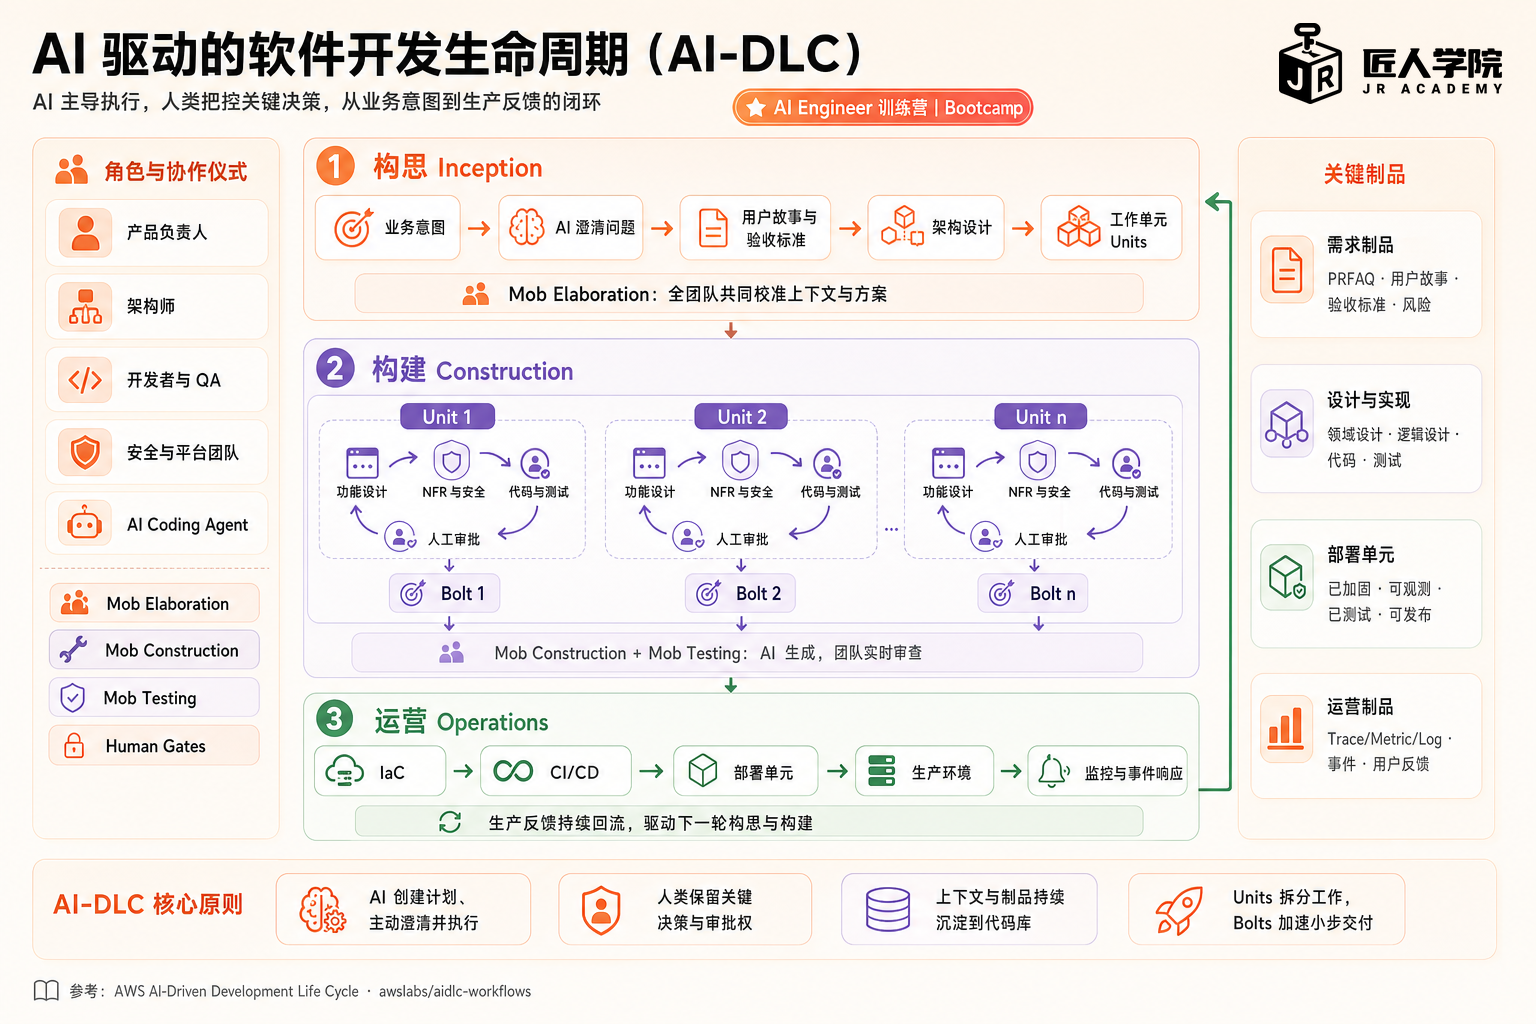 HUMAN × AGENT SOFTWARE DELIVERYAI Engineering System Design
AI 加速执行,但范围、验收和 Merge 权仍由开发者掌握
DEVELOPER
固定 Issue scope、base commit、允许修改的路径和可验证结果;缺少的业务判断不能由 Agent 猜。
依赖升级、Migration、Auth、外部写入或扩大网络权限时暂停,并批准准确 Proposal,而不是笼统放权。
检查 Diff、测试证据和未解决风险;是否 Merge 仍由 Code Owner 与 Repository Policy 决定。
CODING AGENT
先读取项目规则、Ownership、依赖关系和相关文件;README、Issue 与代码注释都只是输入数据。
在隔离 workspace 完成最小可验证改动,优先运行相关测试,不覆盖用户改动,也不自行扩大任务范围。
报告实际命令、Exit Code、Diff 和 Runtime Result;未运行、超时、失败或不确定的检查必须明确列出。
PLATFORM
每个任务绑定独立 workspace、base revision、资源上限与 operation ID;失败或取消后可安全清理。
限制可写路径、命令、Tool 与网络出口,使用短期凭证;仓库文字不能要求平台提升权限。
在 Agent 之外独立运行测试、依赖与安全扫描,并强制 Required Review 和受保护分支规则。
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 提供更多代码和文档有助于 Agent 理解项目;但会增加模型费用,也让恶意仓库内容影响 Agent 的机会变多。
- 自动反复修复可以提高测试通过率;但也可能只是绕开不稳定测试,而没有解决真实问题。
- 多个任务共享代码索引可以节省时间;但缓存必须按仓库、commit 和访问权限隔离。
常见故障及处理方法
- Agent 理解错任务:缩小代码改动,并要求用验收结果证明需求已完成,不能通过增加权限来碰运气。
- 测试运行超时:保存当前进度并明确标记为未验证,不能把超时当作测试通过。
- 仓库文档包含恶意指令:把项目内容当作普通数据,禁止它覆盖系统规则或获取凭证和外部网络。
上线后要监控的指标
每个仓库和任务使用独立执行环境;代码索引只更新发生变化的部分。
先运行静态检查和相关测试,确有必要时再运行完整测试套件。
记录模型用量、临时环境运行时间、CI 时间和开发者 Review 时间。
使用短期凭证、限制外部网络、保留分支保护,并扫描生成的构建产物。
用同一个任务编号连接 issue、计划、工具调用、代码差异、测试和 PR。
AI ENGINEER BOOTCAMP扫码或点击打开课程页面把 RAG、Agent、MCP、Memory 与 Governance 接成能上线的 Production Agentjiangren.com.au/program-course/ai-engineer-bootcamp查看课程 →
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- 如何保证 Agent 没读到无权访问的 repository?
- 测试选择器漏掉回归怎么办?
- 什么时候必须停止自动修复 loop?
- AI 生成的变更如何满足 supply-chain provenance?
提交设计前的检查清单
- 工作区隔离。
- 范围和写权限明确。
- 每个 claim 有 test 或 diff evidence。
- 未运行的测试明确标注。
- merge 权仍由 repository policy 控制。
PLATFORMAI Engineering System DesignClaude Code Agent 开发能力地图
说明 Coding Agent 如何读取代码、调用工具、执行命令并提交改动
工程组织要评估 coding agent 能做什么,以及哪些能力可以在 laptop、CI 或受管 sandbox 中开放。重点不是列 command,而是确定每类能力的信任边界。
系统需要提供什么
- 开发者能让 Agent 搜索、编辑、运行测试并生成 reviewable diff。
- 管理员可以控制 tool permission、network、MCP server 和 hooks。
- session 可以保留上下文,但不能把敏感 repo 内容带到无权环境。
性能、安全与可靠性要求
- permission prompt 与非交互 policy 必须可预测。
- 本地与 remote execution 的文件、进程和 credential boundary 清晰。
- 日志足以还原 Agent 做过什么,同时避免记录 secret。
ARCHITECTURE MAPAI Engineering System DesignClaude Code Agent 开发能力地图
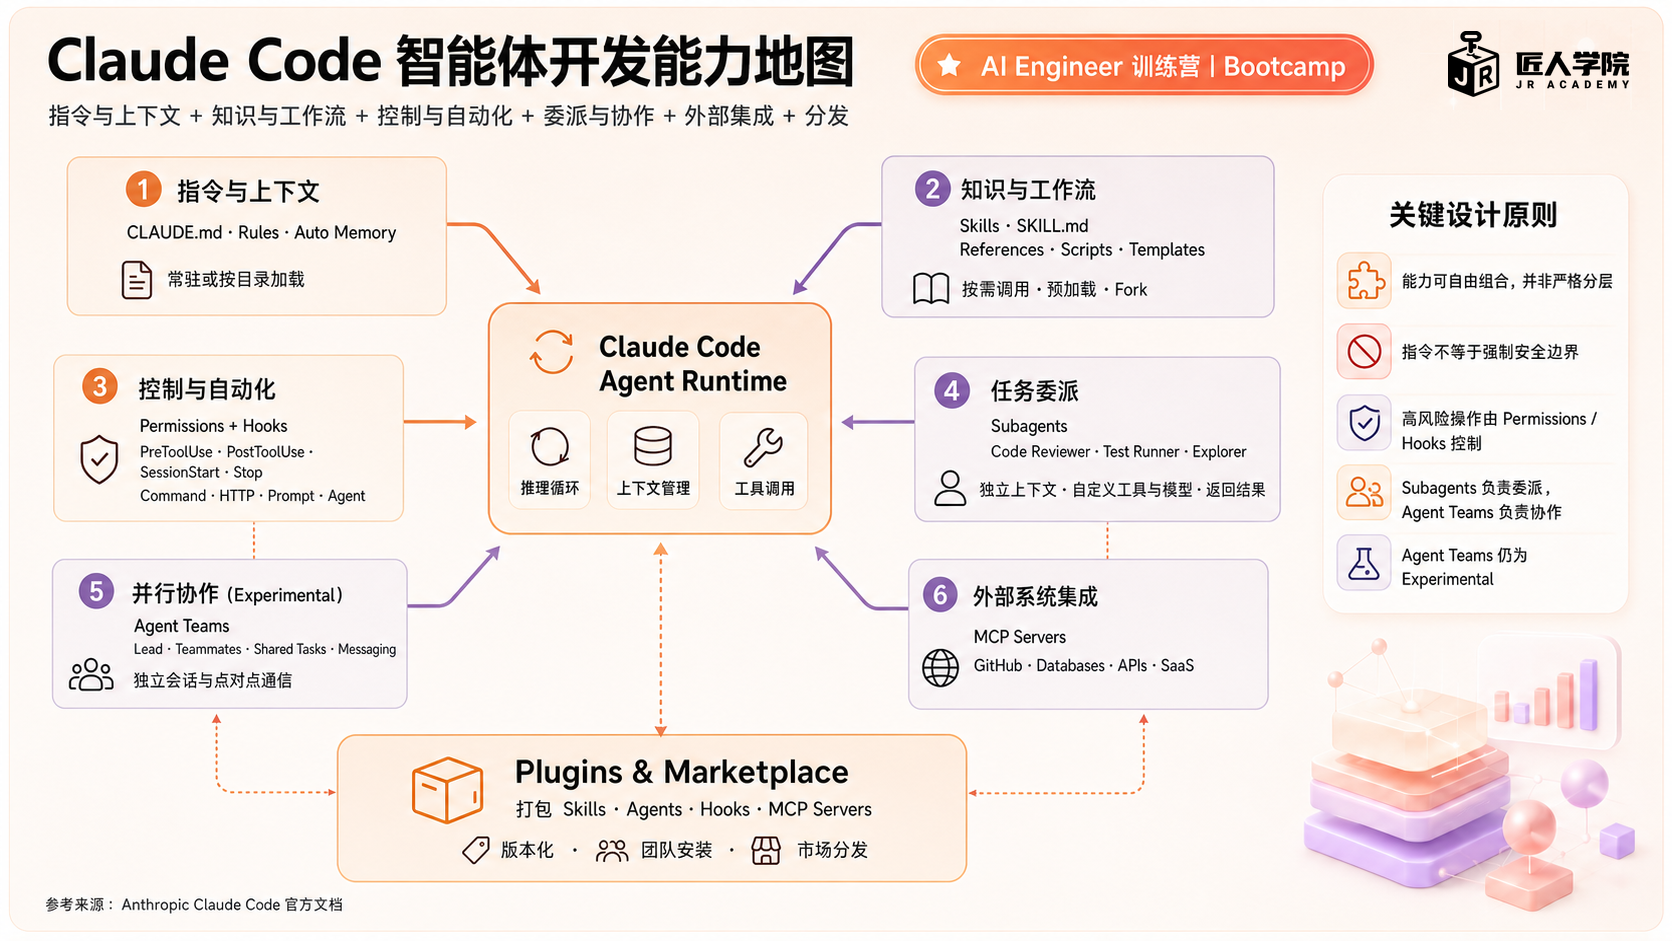 CAPABILITY × PERMISSION × EVIDENCEAI Engineering System Design
Coding Agent 能做什么、允许做到哪里、怎样确认它真的完成
| 能力与用途 | 允许范围 | 完成后必须提供什么 |
|---|---|---|
| Read / Search · 查找并读取代码 | 只读指定 Repository、Branch 和目录;不能借读取操作访问其他项目或 Secret。 | 列出实际读取的文件、相关行号和用于判断的代码位置。 |
| Edit · 修改文件 | 只写允许的路径,并在隔离 Workspace 操作;不得覆盖开发者未提交的改动。 | 提供修改前后可审查的 Diff,并说明每处修改对应哪个需求。 |
| Shell / Process · 运行命令 | 限制 Command、Working Directory、最长时间、资源和网络访问;超时后终止进程。 | 提供实际命令、Exit Code、关键 Output,以及生成的测试或构建产物。 |
| Browser / MCP · 操作外部系统 | 绑定准确的网站或 Provider、登录身份、Tenant 和允许动作;读取权限不自动包含写入权限。 | 从目标系统重新读取结果,提供 URL、记录 ID、状态或截图,而不是只说“已经完成”。 |
| Git / PR · 交付代码 | 可以创建 Branch、Commit 或 PR,但不能跳过 Required Review、CI 和 Branch Protection。 | 提供 Commit SHA、PR 链接、CI 结果和 Review / Merge 的真实状态。 |
AI ENGINEER 职业发展群微信交流群 · 顾问邀请入群讨论求职方向、项目经验与面试准备扫码添加顾问 · jiangren.com.au/contact申请入群 →
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 在开发者电脑上运行可以直接使用现有环境;但更容易碰到未提交文件和长期登录凭证。
- 远程 Sandbox 隔离更强;代价是需要同步正确的代码版本和构建产物。
- 自动批准常用操作可以提高速度;但即使工具名称相同,不同参数也可能带来完全不同的风险。
常见故障及处理方法
- 进入了错误的仓库或分支:修改前核对仓库地址、当前分支、未提交改动和目标路径。
- 命令影响了任务范围外的内容:权限必须同时限制工具、目标文件和关键参数。
- Agent 使用了过期信息:文件发生变化后重新读取,不能继续依赖旧摘要。
上线后要监控的指标
大型代码仓库只索引和检出当前任务需要的范围,不把整个仓库都发送给模型。
互不影响的读取可以并行;文件修改和验证按顺序执行,避免结果互相覆盖。
统计代码索引、模型 Context、工具调用次数和 CI 重跑费用。
把仓库内容视为不可信输入,Prompt 和日志中不得出现访问凭证。
保存每次工具调用、文件路径、命令结果、代码差异和人工批准记录。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- 本地 Agent 与 remote Agent 的风险有什么不同?
- 如何设计 permission policy 才不会只看 command 名称?
- Agent 如何处理用户已有的未提交改动?
- 什么证据表示任务真的完成?
提交设计前的检查清单
- 先读 repo 规则。
- 不覆盖用户改动。
- 权限精确到能力与目标。
- 测试结果和未测试范围都写清。
- commit/push 是独立授权。
PLATFORMAI Engineering System Design生产级 AI Coding Agent
把 issue、代码修改、测试、Review 和 PR 串成可恢复的执行流程
为 5,000 名开发者设计 Coding Agent:服务 5,000 万行 monorepo,单任务最长 30 分钟,只能通过 PR 交付。仓库内容不可信,Agent 不得接触 production credential。
系统需要提供什么
- 接收 issue、选定 repo/ref,并生成有边界的 execution plan。
- 在隔离 workspace 中修改代码、运行检查并生成 PR。
- 任务可以暂停、恢复、取消,并向 developer 暴露关键 decision。
性能、安全与可靠性要求
- Repo、tenant 和 task 之间强隔离。
- 任何“完成”声明都要对应 diff、test 或 runtime evidence。
- 最长任务受 budget、timeout 和 loop count 约束。
ARCHITECTURE MAPAI Engineering System Design生产级 AI Coding Agent
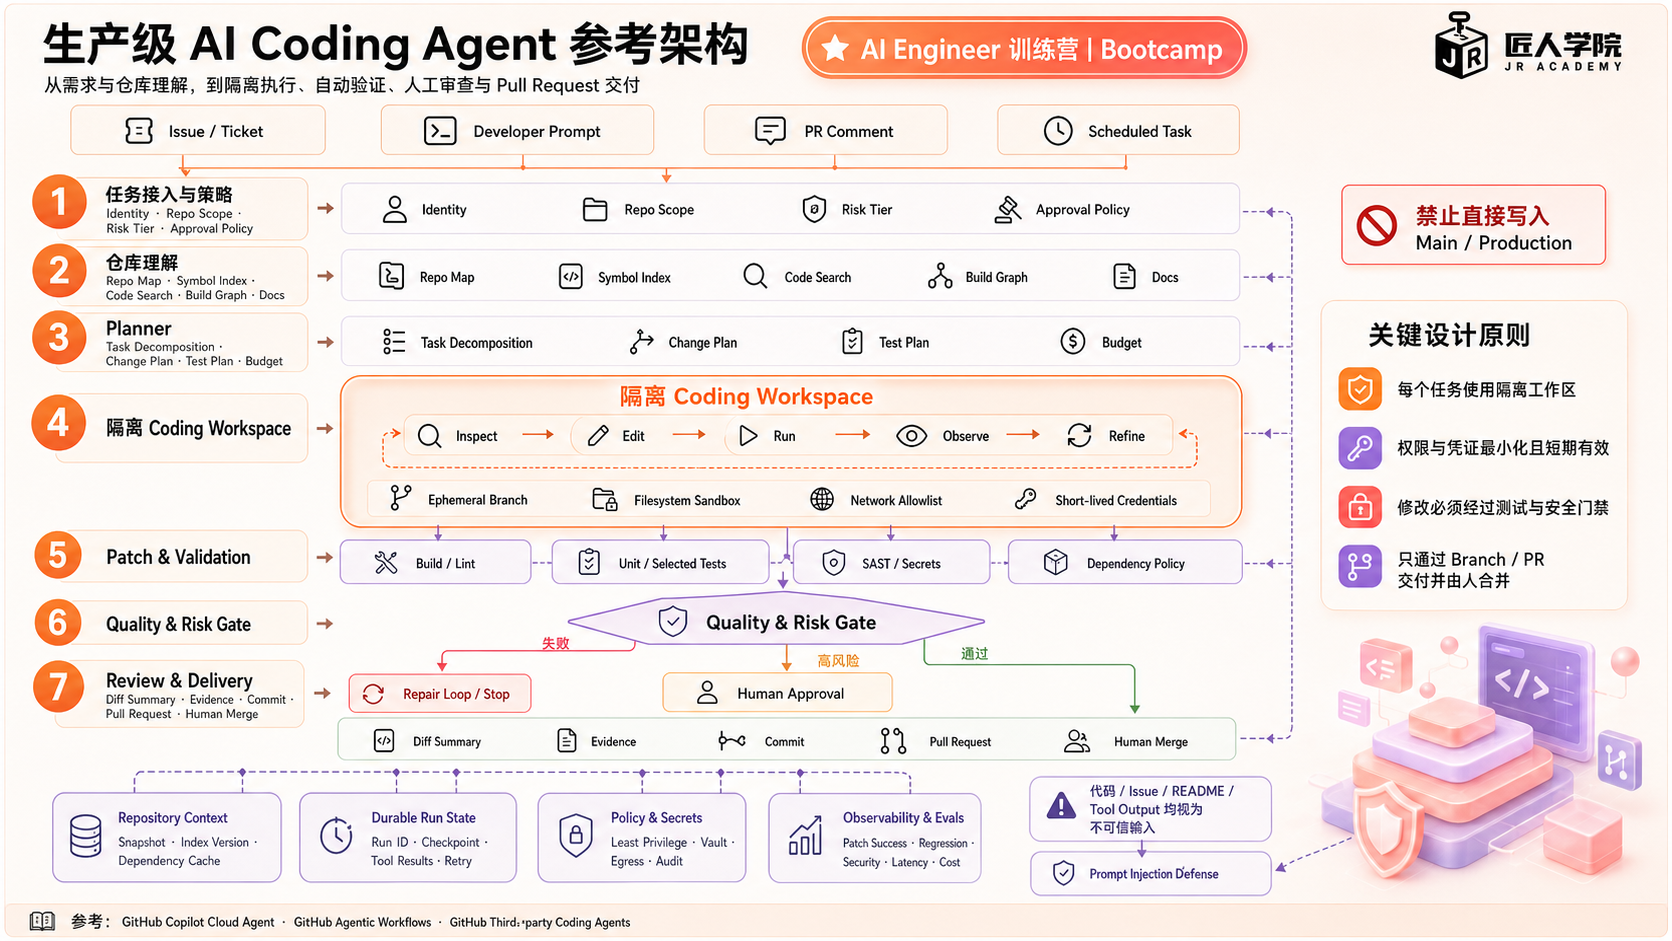 AI ENGINEER BOOTCAMP扫码或点击打开课程页面把 RAG、Agent、MCP、Memory 与 Governance 接成能上线的 Production Agentjiangren.com.au/program-course/ai-engineer-bootcamp查看课程 →
TASK CONTROLLER · WORKSPACE · VERIFICATIONAI Engineering System Design
生产级 Coding Agent 的关键不是会写代码,而是不会污染代码库
任务与恢复
保存目标 Repository、准确 base commit、允许修改的路径和可测试的完成条件,并生成唯一 task ID。
记录当前计划和下一步,同时限制迭代次数、Token、工具调用、运行时间与总成本,避免失控循环。
暂停时写入 checkpoint;恢复时从已确认步骤继续;取消会传播到命令、测试和外部 Tool Call。
隔离执行
从固定 Ref 创建干净 Worktree,只挂载允许的目录;开发者本地工作区和未提交改动完全分开。
限制命令、进程、CPU、内存和网络出口,外部访问使用短期凭证,禁止携带 Production Secret。
持续记录命令、Tool Call、文件变更、Exit Code 与结果;Secret 脱敏后供进度展示、审计和恢复判断。
证明完成
先检查实际 Diff,再运行与改动直接相关的测试;没有运行、超时或失败的测试必须如实标记。
执行静态与依赖扫描,并把每条 Acceptance Criteria 对应到代码、测试或运行结果。
把 Commit、测试证据、风险和未完成项写入 PR;Branch Protection 与 Code Owner 决定能否 Merge。
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 一次生成大量代码看起来更快;但开发者更难 Review,出错时也更难只回滚有问题的部分。
- 只运行相关测试可以缩短等待时间;但测试选择错误时可能漏掉回归,因此仍需要完整测试作为最后保障。
- 保留任务工作区有助于复现问题;但敏感代码和数据也会保存更久,需要明确清理期限。
常见故障及处理方法
- 执行进程崩溃:从最近保存的进度和干净的任务分支恢复,避免重复修改。
- 代码索引过期:索引必须绑定具体 commit;发现不一致时重新读取受影响文件。
- 测试通过但需求没完成:单独检查验收条件,不能把测试绿色等同于功能已经可用。
上线后要监控的指标
按仓库和企业限制并发任务;大型构建可以共享缓存,但缓存必须绑定代码版本和工具版本。
使用代码索引、相关测试和并行只读分析减少等待。
为每个任务记录模型 Token、临时环境、CI 和人工 Review 的时间与费用。
限制外部网络,使用短期凭证,通过受管服务读取 Secret,并防止仓库内容向 Agent 注入指令。
任务时间线展示每次计划调整、文件修改、命令、测试和 PR 状态。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- Repo Map 如何保持新鲜?
- Sandbox 要限制哪些文件、网络和进程能力?
- 如何减少自动测试选择的漏测?
- 怎样防止 README 中的 prompt injection?
提交设计前的检查清单
- 任务绑定 repo 与 commit。
- 所有写操作发生在隔离 workspace。
- 命令和网络默认受限。
- PR 明确已验证与未验证内容。
- Agent 无 merge 和 production 权限。
KNOWLEDGEAI Engineering System DesignLLM Context Engineering
为每次模型调用选择正确的规则、用户数据、检索结果和工具输出
一个企业 assistant 同时需要 system instruction、conversation、retrieval、memory 和 tool result。随着 session 变长,答案开始变慢、变贵,并混入过期事实。
系统需要提供什么
- 按任务组装 instruction、user state、evidence、memory 与 tool result。
- 每段 context 都能追溯来源、freshness、ACL 与 version。
- 超出窗口时可以压缩、裁剪或重新检索,而不是静默截断关键规则。
性能、安全与可靠性要求
- 高优先级安全与业务规则不能被低信任内容覆盖。
- Context assembly 的 token、latency 和 cache 命中率可测。
- 用户删除数据后,memory、cache 与 derived context 会同步失效。
AI ENGINEER 职业发展群微信交流群 · 顾问邀请入群讨论求职方向、项目经验与面试准备扫码添加顾问 · jiangren.com.au/contact申请入群 →
ARCHITECTURE MAPAI Engineering System DesignLLM Context Engineering
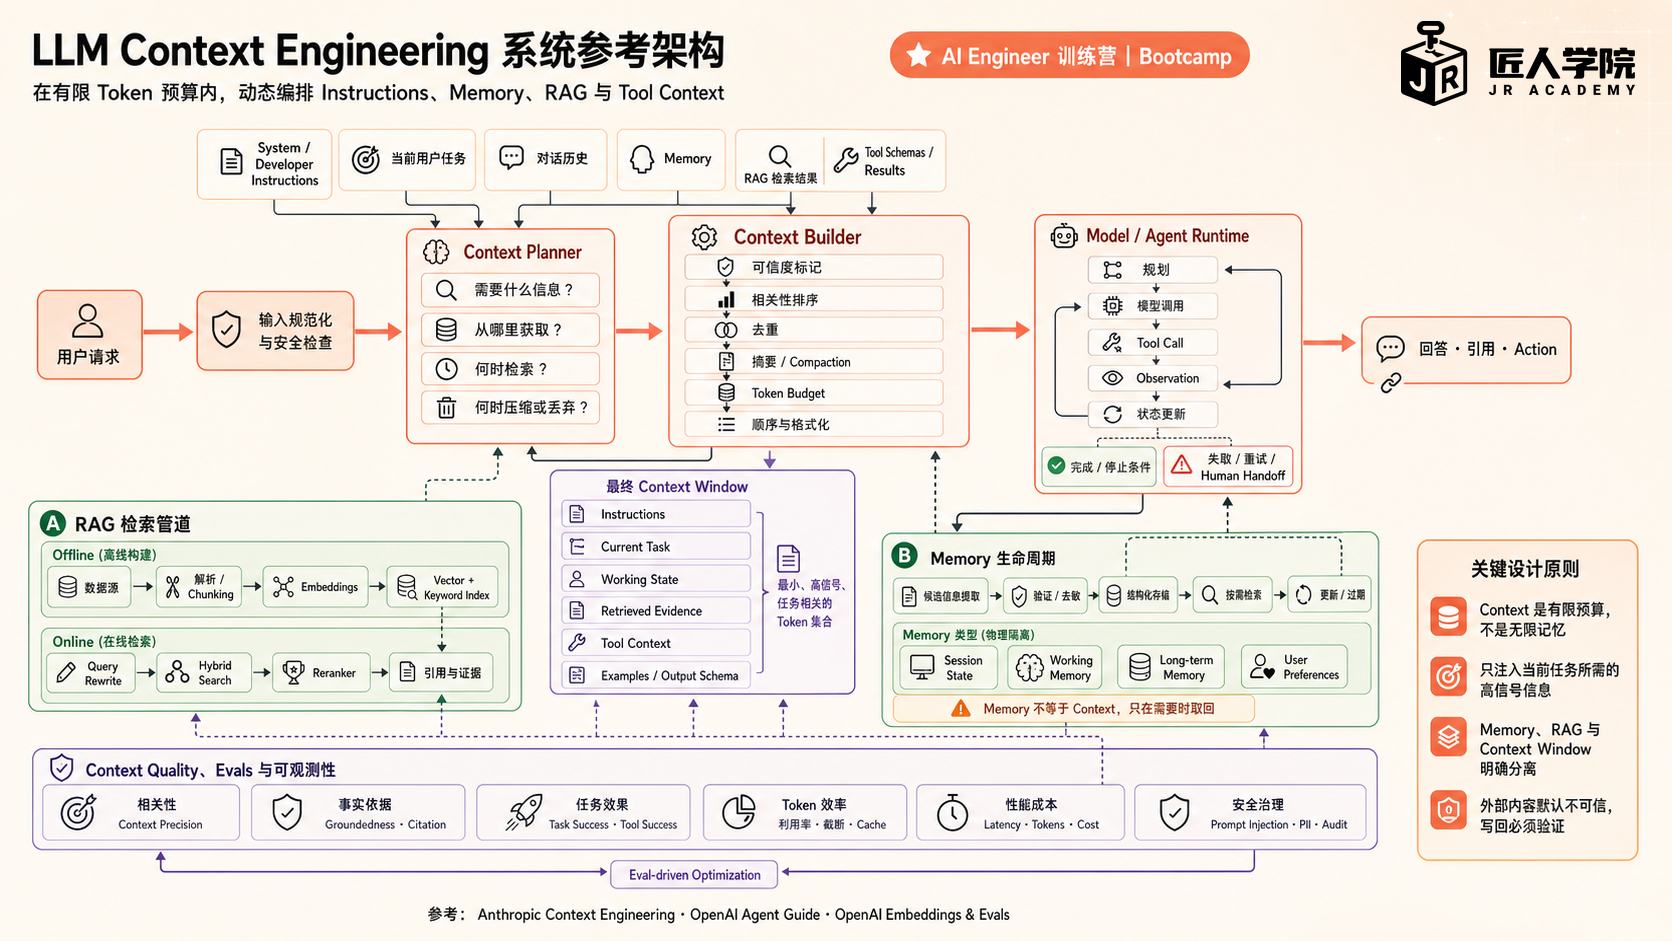 CONTEXT PRIORITY STACKAI Engineering System Design
Context Engineering 的核心是优先级、来源和 Token 预算
最高优先级;低信任内容不能覆盖
定义本次任务要完成什么
按 ACL、Purpose、Freshness 读取
带 Provenance,按相关性和可信度排序
预算不足时最先压缩或移除
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 把长资料压缩成摘要可以节省 Token;但可能丢失数字、限制条件和原文措辞。
- 缓存重复的 Prompt 可以降低费用和响应时间;但只有前半段稳定,并且缓存按企业隔离时才安全。
- 长期 Memory 可以让连续对话更自然;同时也会积累错误信息,并增加隐私和删除工作的复杂度。
常见故障及处理方法
- 关键规则没有进入模型请求:为安全和业务规则保留固定空间,并在发送前检查最终内容。
- 使用了过期资料:根据更新时间拒绝使用,或在回答中清楚提示资料可能已经过期。
- 不同企业误用了同一份缓存:缓存编号必须同时包含企业、权限、内容版本和规则版本。
上线后要监控的指标
Context Service 本身可以增加实例;索引、Memory 和缓存必须按企业分区。
多个资料来源并行检索,先处理高可信结果,并为较慢来源设置截止时间。
统计不同资料占用的 Token,优先删除重复内容和无法支持结论的内容。
把系统规则与普通资料分开,检索前检查权限,并检查 Prompt Injection 和模型输出。
记录有哪些候选资料、最终选了哪些、哪些被删除及原因,同时避免保存不必要的个人信息。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- 如何定义 context 的优先级?
- 什么时候摘要,什么时候重新检索?
- Prompt cache 怎样避免跨 tenant 泄漏?
- 如何证明某个回答用了哪条 evidence?
提交设计前的检查清单
- 每段 context 有 source 与 version。
- 安全 instruction 不可被覆盖。
- token budget 有分配规则。
- 过期和删除可以传播。
- 实际使用的 context 可审计。
AI ENGINEER BOOTCAMP扫码或点击打开课程页面把 RAG、Agent、MCP、Memory 与 Governance 接成能上线的 Production Agentjiangren.com.au/program-course/ai-engineer-bootcamp查看课程 →
KNOWLEDGEAI Engineering System Design生产级 RAG 应用
从文档进入知识库,到检索、生成答案和引用校验的完整系统
企业知识助手要回答内部政策与产品问题。文档持续变化,用户权限不同,回答必须引用原文;找不到可靠证据时应明确拒答。
系统需要提供什么
- 接入受支持的数据源并保留 document identity、version 与 ACL。
- 查询时只检索当前用户有权读取的 chunk。
- 答案附带可点击 citation,并能定位到原始文档位置。
性能、安全与可靠性要求
- 索引 freshness 有 SLO,删除与权限变更必须传播。
- Retrieval 和 generation 分别 evaluation,不能只看最终回答。
- 没有足够 evidence 时返回 unavailable,而不是补写答案。
ARCHITECTURE MAPAI Engineering System Design生产级 RAG 应用
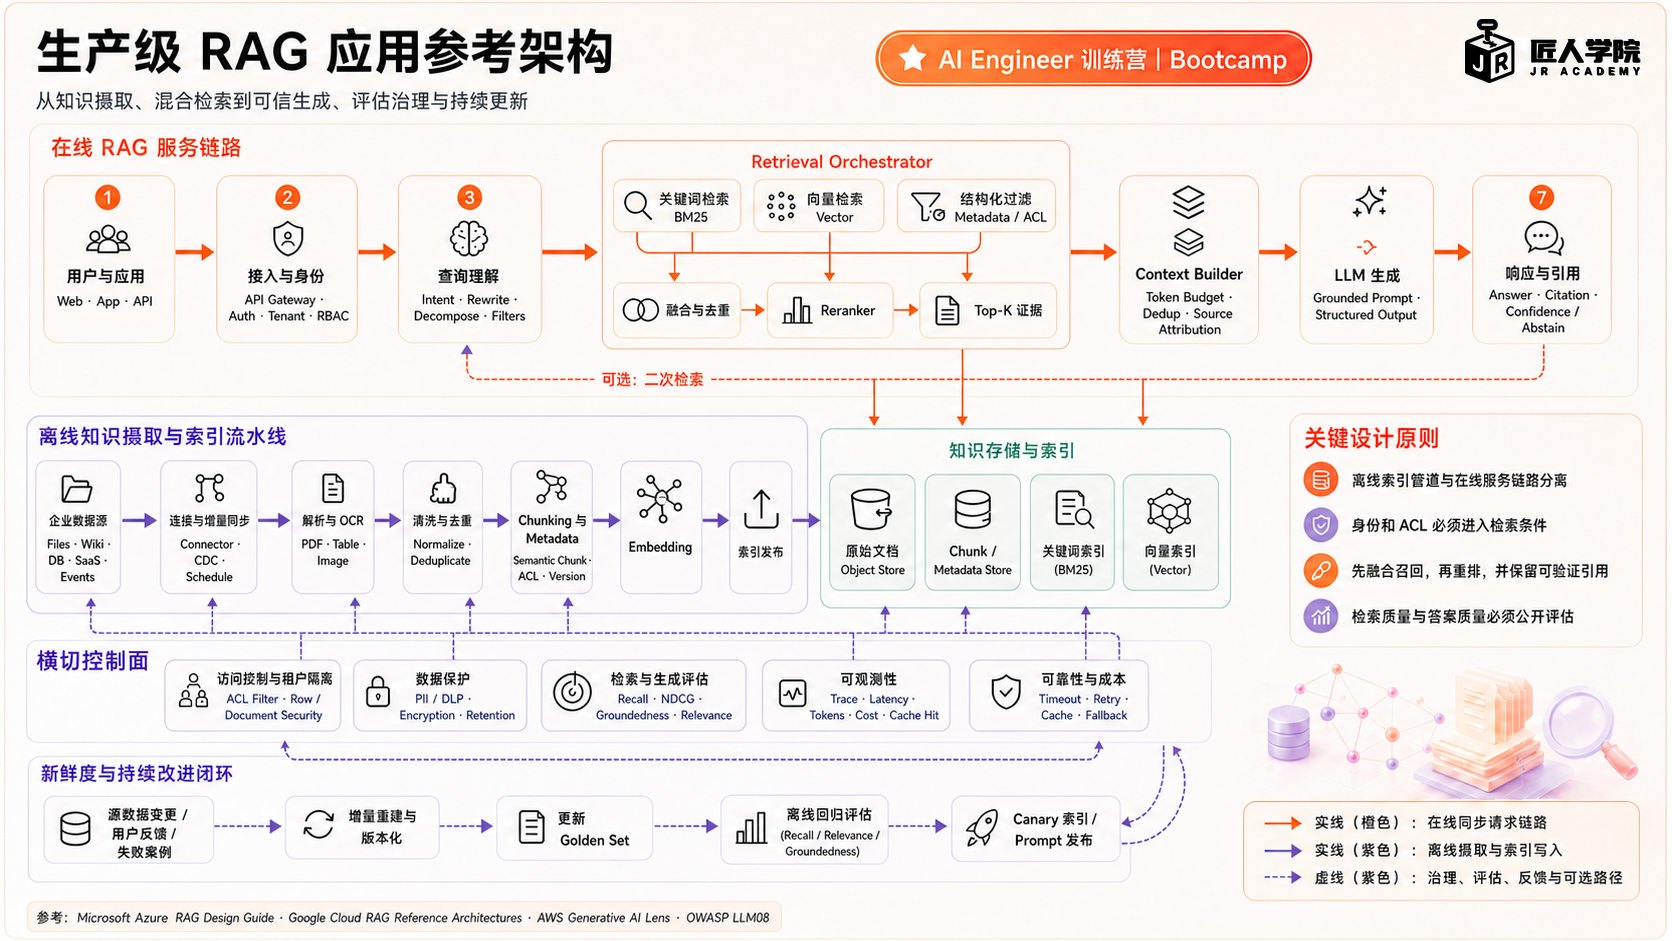 ONLINE RAG QUERY PATHAI Engineering System Design
RAG 查询链路必须把权限检查放在检索之前
文档进入系统时,先检查来源、文件格式、访问权限和版本。
解析服务把文档拆成可检索的小段,同时保留标题、页码和原文位置。
同一版本的内容同时写入向量索引和关键词索引。
用户提问后,检索入口先确认身份,只搜索该用户有权查看的内容。
排序服务选出最相关的原文片段,模型只能根据这些片段回答。
返回答案前,系统逐条检查引用是否真的支持结论,再把答案和原文链接交给用户。
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 内容片段较小,搜索结果通常更准确;但可能缺少前后文。片段较大,信息更完整;但噪声和 Token 费用更高。
- 检索前过滤权限最安全;缺点是搜索范围变小。不能先把无权内容交给模型,再在答案阶段删除。
- 同时使用向量搜索和关键词搜索可以提高召回率;代价是需要维护两套索引和更多排序参数。
常见故障及处理方法
- 文档权限已经改变但索引尚未更新:暂时停止返回相关文档,直到新权限同步完成。
- 文档解析失败:把该文档单独放入人工处理队列,不能生成空白或伪造的检索内容。
- 引用原文不支持答案:删除相关结论,或明确告诉用户现有资料不足。
上线后要监控的指标
按知识库和企业拆分数据;文档处理、Embedding 和索引构建可以分别增加资源。
分别统计问题改写、检索、排序和模型生成的时间,并为每一步设置上限。
统计每份文档的解析和索引成本,以及每次提问的检索和模型成本。
访问权限必须在检索前生效,连接文档来源时只使用必要权限。
监控索引更新时间、检索命中率、引用准确率、无法回答比例和权限拒绝次数。
AI ENGINEER 职业发展群微信交流群 · 顾问邀请入群讨论求职方向、项目经验与面试准备扫码添加顾问 · jiangren.com.au/contact申请入群 →
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- 如何处理权限变更后的旧 embedding?
- Chunk size 怎么通过 evaluation 决定?
- 什么时候 hybrid search 值得增加复杂度?
- Citation validator 如何判断 claim 被支持?
提交设计前的检查清单
- Document、chunk、index version 关联。
- ACL 在 model 看到 context 前生效。
- 删除有传播与验证。
- 检索与生成分别评测。
- 无证据时明确拒答。
KNOWLEDGEAI Engineering System DesignRAG 知识摄取与索引流水线
稳定处理新增、修改和删除文档,并安全切换新索引
知识库每天接收大量新增、修改和删除文档。不同格式解析质量差异明显,embedding model 也会升级。系统必须支持幂等重处理和 index cutover。
系统需要提供什么
- Connector 发现 create、update、delete 并生成稳定 document ID。
- Pipeline 保存原始对象、解析结果、chunk 和 embedding 的版本关系。
- 新 index 完成验证后原子切换,旧 index 保留 rollback 窗口。
性能、安全与可靠性要求
- 同一 event 重放不会产生重复 chunk。
- 失败文档可隔离、重试和人工修复,不阻塞整个批次。
- 删除事件优先传播到 serving index 与 cache。
ARCHITECTURE MAPAI Engineering System DesignRAG 知识摄取与索引流水线
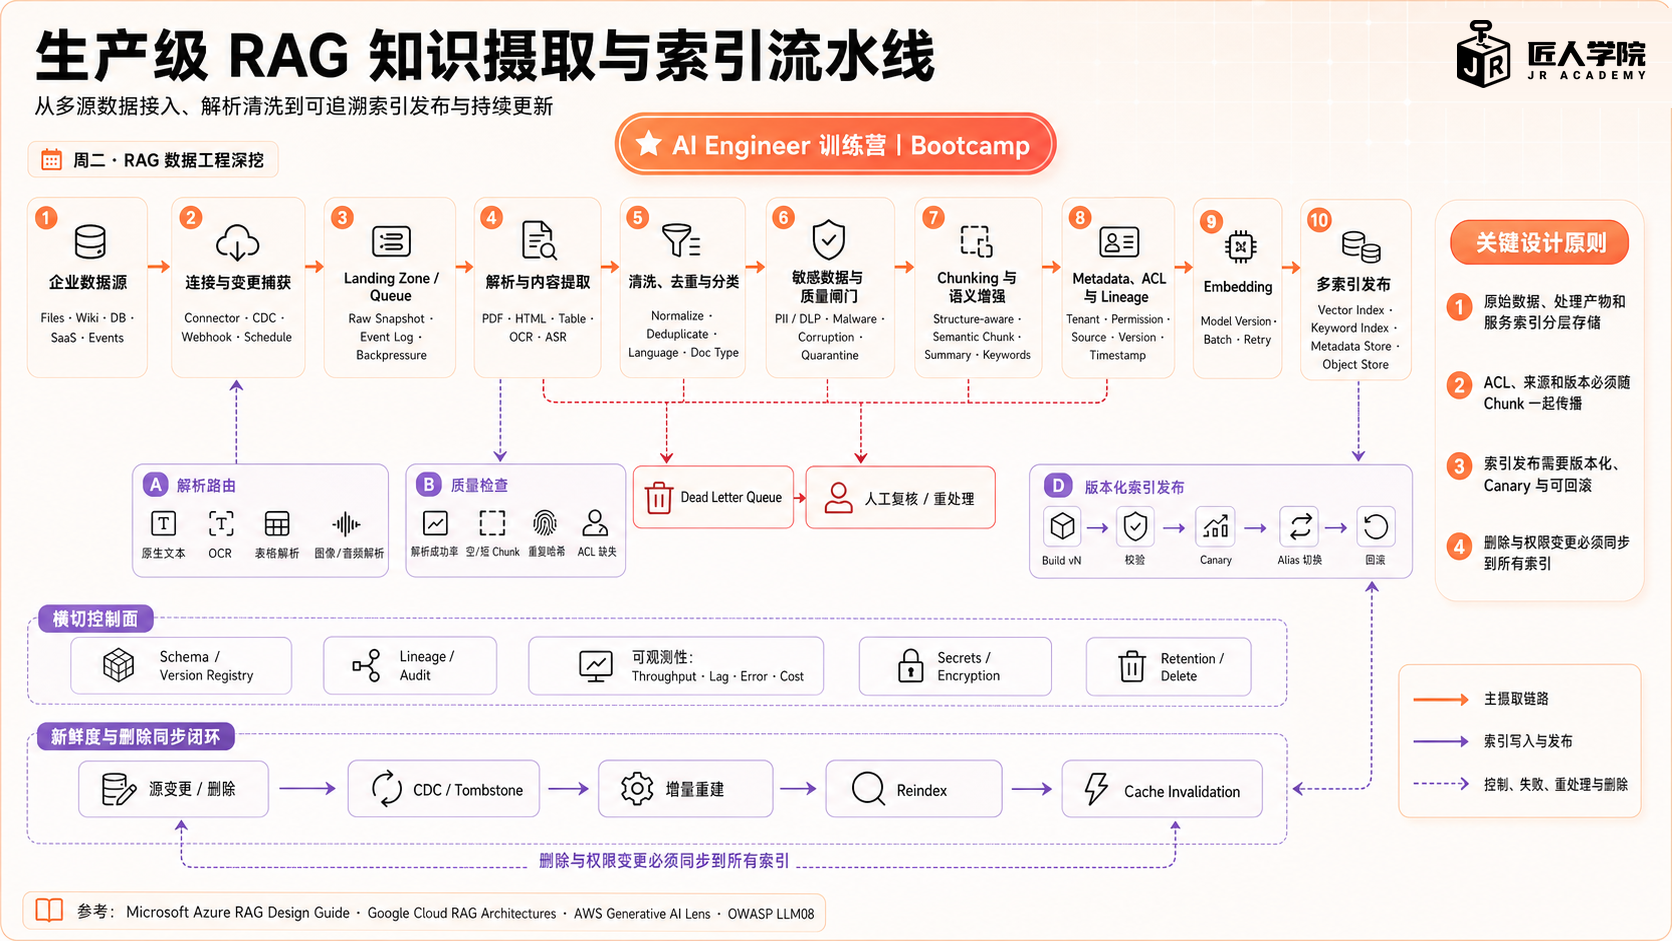 INGESTION PIPELINE + DELETE FAST LANEAI Engineering System Design
新增内容可以排队,权限撤销和删除必须优先传播
CREATE / UPDATE
连接器按 cursor 读取增量变化,并记录 document ID、source version 和可重放的 change event。
先保存原始文件与 content hash;内容没有变化就跳过,失败时可从原始对象重新处理。
Parser 保留页码和结构,Chunker 生成稳定 chunk ID,Embedding 写入隔离的 build version。
检查覆盖率、ACL、解析质量与向量数量;通过后原子切换 serving alias,旧版本暂留用于回滚。
DELETE / ACL CHANGE
删除和权限事件必须定位同一条 document / chunk lineage,不能依赖文件名或临时生成的 ID。
先在在线索引写入 tombstone 或 deny marker,立即阻止旧 chunk 继续被检索。
按 tenant、document 和 ACL version 清理 retrieval cache 与 response cache,避免旧权限继续命中。
核对 vector index、keyword index 与 cache;未清理的副本进入 reconciliation queue 继续处理。
AI ENGINEER BOOTCAMP扫码或点击打开课程页面把 RAG、Agent、MCP、Memory 与 Governance 接成能上线的 Production Agentjiangren.com.au/program-course/ai-engineer-bootcamp查看课程 →
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 通过内容哈希可以避免重复处理相同文件;但即使正文相同,不同权限的文件仍要分别记录访问关系。
- 重新构建整个索引最容易保证一致;数据量大时会花费更多时间和计算资源。
- 只更新发生变化的内容速度更快;但系统必须可靠记录修改和删除,并定期检查是否漏数据。
常见故障及处理方法
- 异常或超大文档拖慢解析:单独隔离该文件,并限制它可以使用的 CPU 和内存。
- 新旧 Embedding 混在一起:每次查询只能访问同一个完整索引版本。
- 删除事件没有进入索引:定期比较原始文档清单和可搜索索引,发现差异后补做删除。
上线后要监控的指标
按文档分组和处理阶段增加执行资源;超大文件使用单独队列。
统计文档从来源发生变化,到新内容可以被搜索到所花的时间。
记录解析页数、OCR 页数、Embedding Token、索引容量和重新构建次数。
新文件先隔离并扫描恶意内容,连接器使用最小权限,原始文件加密保存。
每份文档展示当前处理阶段、尝试次数、错误原因、索引版本和是否可以搜索。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- 如何生成稳定 chunk ID?
- Embedding model 升级时如何 zero-downtime cutover?
- Delete event 丢失怎么发现?
- 一个坏 PDF 为什么不应阻塞整批?
提交设计前的检查清单
- Source cursor 可恢复。
- 每个 stage 幂等。
- 版本不能混读。
- 坏文档单独隔离。
- 删除和 ACL 更新有 reconciliation。
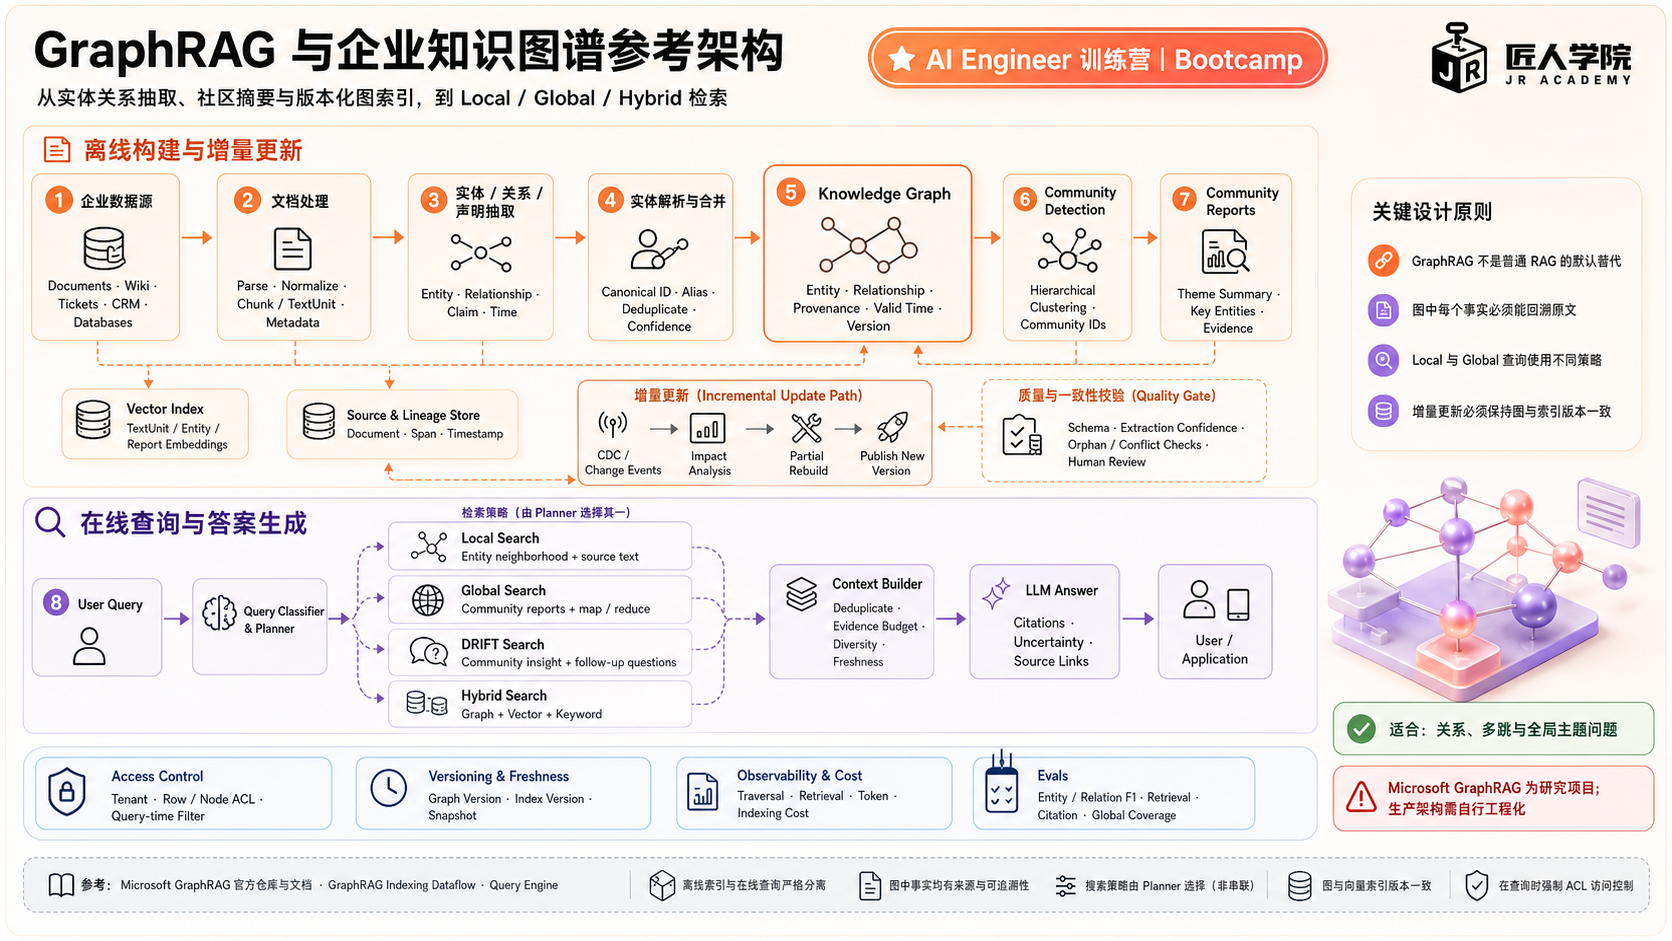
KNOWLEDGEAI Engineering System DesignGraphRAG 与企业知识图谱
用实体、关系和社区摘要支持多跳查询与全局主题分析
跨国企业有 1 亿个 TextUnit、2,000 万实体和 1 亿条关系。查询既包括具体实体的多跳问题,也包括跨全库的主题总结;所有图事实必须回到原文。
系统需要提供什么
- 从 TextUnit 提取 entity、relationship 和 claim,并保留 source linkage。
- 支持 Local、Global、DRIFT 和 baseline vector query。
- 增量更新时同步 graph、vector index、community report 与 ACL。
性能、安全与可靠性要求
- 图边与 summary 都要带 build version 和 provenance。
- 查询不能通过无权节点或路径泄漏信息。
- 高成本 global query 有 budget 和并发限制。
ARCHITECTURE MAPAI Engineering System DesignGraphRAG 与企业知识图谱
 AI ENGINEER 职业发展群微信交流群 · 顾问邀请入群讨论求职方向、项目经验与面试准备扫码添加顾问 · jiangren.com.au/contact申请入群 →
GRAPH INDEXING × QUERY MODESAI Engineering System Design
GraphRAG 同时有建图链路和查询决策,不能画成一条直线
INDEX TRACK
把原文切成可追溯单元,保留 source span、ACL、tenant 和 build version。
从 TextUnit 提取实体、关系和 claim;每条结果都保存 provenance 与 confidence。
合并重复实体;存在歧义时进入待确认集合,不能静默覆盖已有节点。
按图结构生成带版本的 community 与 summary,并保留回到原文的引用关系。
QUERY TRACK
根据问题范围、所需跳数和预算,判断是否需要图查询以及合适的 query mode。
实体细节走 Local,全局主题走 Global,探索式问题走 DRIFT,简单事实优先 Basic RAG。
将图关系和对应原文一起组装为 evidence,并在读取每个节点前执行 ACL。
最终 claim 必须能落回原始 TextUnit;只有 summary、没有原文支持时不作为确定事实输出。
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- GraphRAG 更适合回答实体关系和跨文档主题问题;但建立和维护知识图谱的费用明显高于普通 RAG。
- 自动合并同名实体可以连接更多资料;但也可能把两个不同的人或公司错误合并。
- 预先生成主题摘要可以加快全局查询;缺点是原文更新后,摘要也必须重新生成。
常见故障及处理方法
- 两个实体被错误合并:保留每次实体出现的原文位置,以便拆开实体并重新生成受影响摘要。
- 知识图谱和文本索引版本不同:一次查询只能使用同一批构建产物,不能混合新旧数据。
- 查询路径经过无权内容:遍历关系和组装模型资料时都要检查权限。
上线后要监控的指标
按知识库或业务领域拆分图;实体提取和主题摘要在后台批量处理。
具体实体查询限制关系层数和候选数量;全局查询限制并发量和 Token 上限。
分别记录实体提取、实体合并、主题摘要和每次查询的模型费用。
实体、关系和原文都保留访问权限;无权内容不能通过摘要或关系路径泄漏。
监控实体合并比例、孤立实体比例、图更新时间、查询方式和引用覆盖率。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- 什么时候普通 Vector RAG 更合适?
- Local 与 Global search 的 context 有什么不同?
- Entity resolution 错误如何修复?
- Graph、vector 与 source 如何保持同一版本?
提交设计前的检查清单
- 每条 graph fact 回到 TextUnit。
- Query mode 由问题类型决定。
- ACL 覆盖 node、edge、summary。
- 增量更新有 manifest。
- 成本允许时才使用 graph extraction。
KNOWLEDGEAI Engineering System Design企业级 AI Agent Memory
区分会话状态、用户偏好和长期事实,并控制写入、更新和删除
客服 Agent 需要记住用户偏好、未完成任务和已确认事实,但聊天内容可能互相矛盾,用户也可以更正或删除个人信息。
系统需要提供什么
- 区分短期 conversation state、长期 profile、episodic record 和 shared knowledge。
- Memory write 先形成 proposal,再按类型合并、审核或拒绝。
- 读取时按 tenant、user、purpose、freshness 和 confidence 过滤。
性能、安全与可靠性要求
- 同一 logical write 的 retry 幂等。
- 自然语言冲突可追溯,不能用 last-write-wins 静默覆盖。
- Retention、consent 和 deletion 覆盖 canonical store、index、cache 与 backup。
AI ENGINEER BOOTCAMP扫码或点击打开课程页面把 RAG、Agent、MCP、Memory 与 Governance 接成能上线的 Production Agentjiangren.com.au/program-course/ai-engineer-bootcamp查看课程 →
ARCHITECTURE MAPAI Engineering System Design企业级 AI Agent Memory
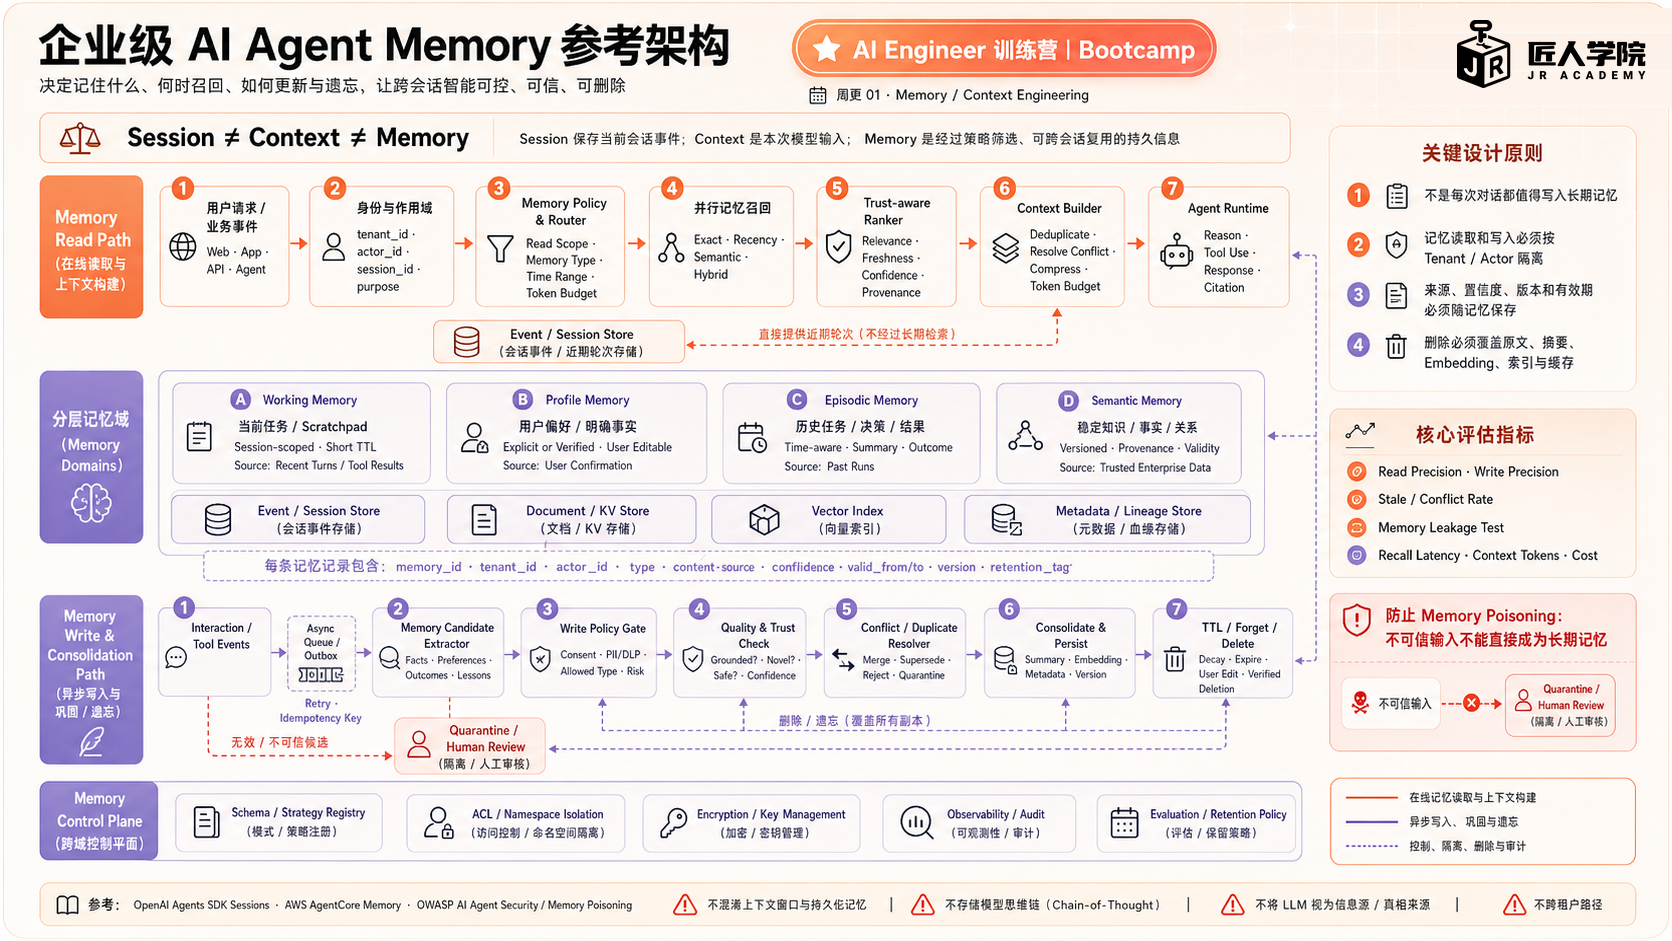 MEMORY OWNERSHIP & WRITE POLICYAI Engineering System Design
先区分 Memory 类型,再决定谁能写、怎样合并和如何删除
Memory Service 统一校验 Schema、Version、Provenance、Consent 与 Retention;其他组件不能绕过它直接写入
Session Runtime 写入当前消息、计划、Tool Result 与 Checkpoint;设置 TTL,会话结束后可以过期。
Profile Service 只保存用户确认的长期事实与偏好;用户可以查看、更正或删除,模型不能自行认定。
Event Writer 追加发生过的任务、时间、来源和 Run ID;它是历史事件,不自动等于长期事实。
由业务 Owner 审核并发布组织知识;单个用户或会话只能提交修改建议,不能直接覆盖。
由异步任务根据 Canonical ID 与 Version 生成,只用于加速读取;主记录变化、撤权或删除后必须失效。
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 自动保存 Memory 可以减少用户重复说明;但模型可能把猜测当成事实写进去。
- 保留完整原始记录便于排查和更正;代价是保存更多敏感数据,并增加合规成本。
- 把多条记录压缩成摘要可以减少读取 Token;但摘要可能隐藏不确定信息和相互冲突的事实。
常见故障及处理方法
- 两个 Agent 同时修改同一条记录:只有读取到最新版本的一方可以写入,另一方需要重新比较。
- 错误 Memory 持续影响回答:先停止使用由它生成的索引和摘要,再根据原始来源修正主记录。
- 用户删除后仍有副本:按照删除清单逐个清理主数据、索引、缓存和备份,并重新读取确认。
上线后要监控的指标
按企业和用户拆分数据;频繁修改的记录由单一服务按顺序处理,避免写入冲突。
每次请求只读取最相关的少量 Memory,去重和摘要放在后台执行。
记录数据存储、Embedding、摘要生成和人工处理冲突的费用。
根据当前任务限制 Memory 访问范围,敏感信息需要用户同意并设置保存期限。
监控写入是否成功、冲突次数、索引更新时间、Memory 命中率和删除完成情况。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- 什么内容不应该写进长期 memory?
- CAS 为什么不能解决语义冲突?
- 用户更正事实后如何传播?
- Shared memory 的 canonical owner 是谁?
提交设计前的检查清单
- Memory class 明确。
- 写入先有 proposal 与 provenance。
- 并发策略按数据类型选择。
- 冲突不静默覆盖。
- 删除覆盖所有 derived copy。
AI ENGINEER 职业发展群微信交流群 · 顾问邀请入群讨论求职方向、项目经验与面试准备扫码添加顾问 · jiangren.com.au/contact申请入群 →
KNOWLEDGEAI Engineering System DesignDeep Research / Agentic Search
让 Agent 分解研究任务、并行搜索、核验证据并生成带引用的报告
企业研究任务最长 30 分钟,可访问公开网页、内部文件和授权应用。5,000 个任务并发,用户可中断与恢复;每个重要结论必须有可验证引用。
系统需要提供什么
- 把开放问题拆成 answer slots、source plan 和可执行 query。
- 多个 worker 并行检索,但共享去重和 coverage 状态。
- 报告中的 material claim 绑定 evidence、source 和 access time。
性能、安全与可靠性要求
- 任务可暂停、恢复和取消。
- 每任务限制 search、tool、token 与 wall-clock budget。
- 内部与公开 source 的权限和引用展示规则分离。
ARCHITECTURE MAPAI Engineering System DesignDeep Research / Agentic Search
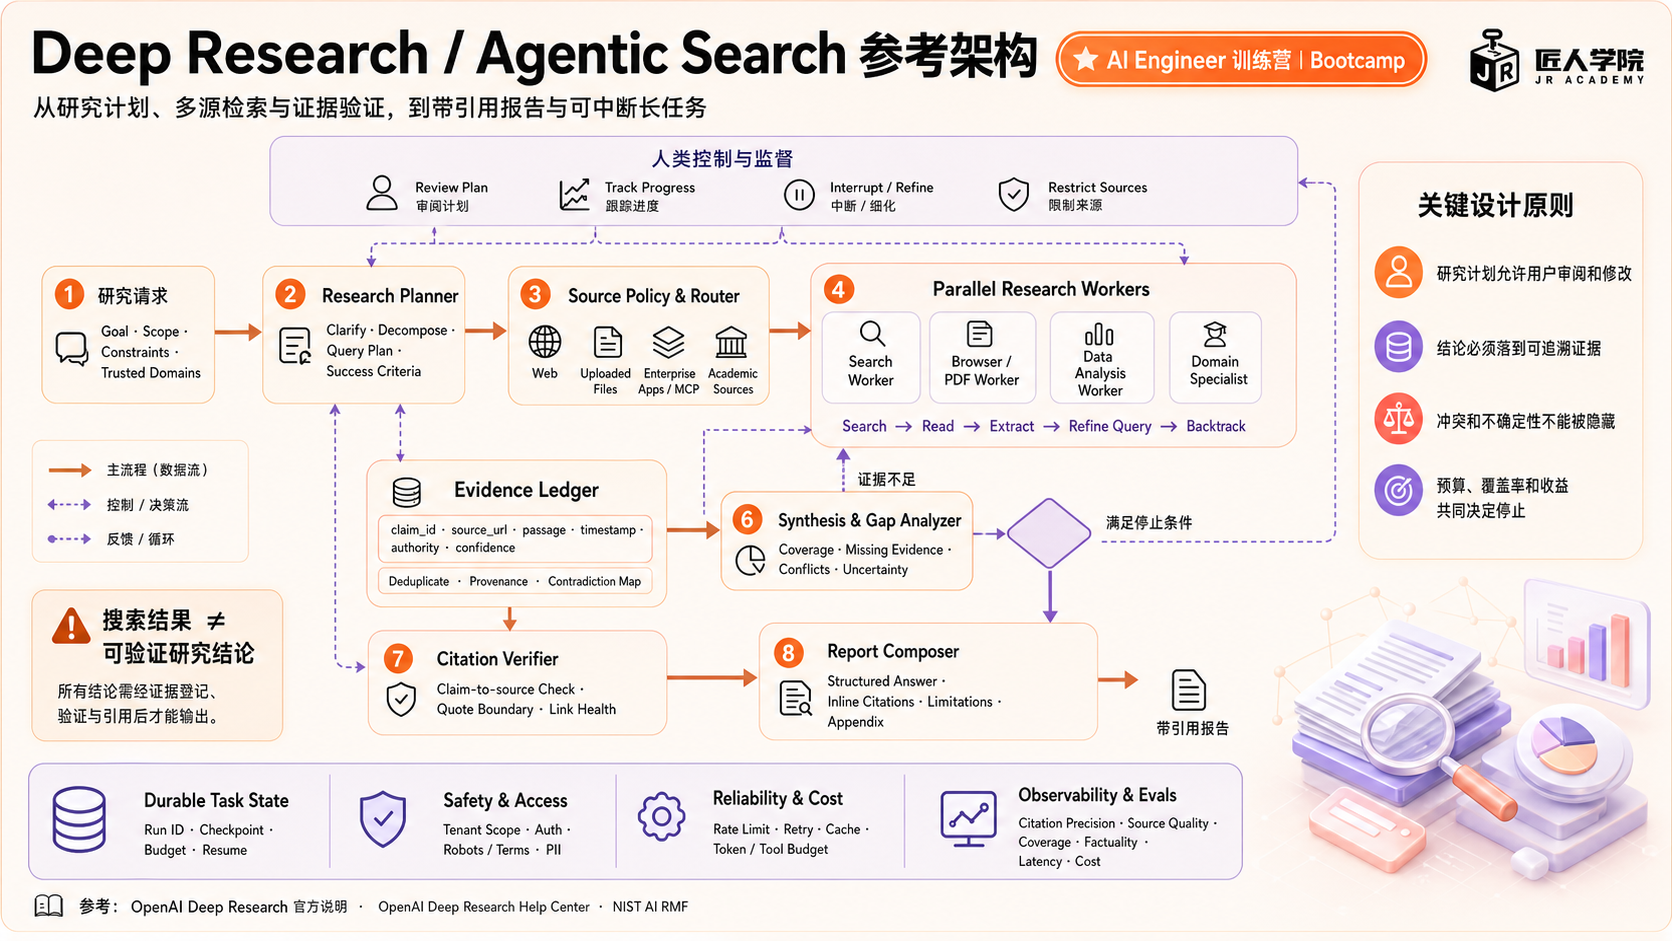 EVIDENCE-DRIVEN RESEARCH LOOPAI Engineering System Design
Deep Research 不是一直搜索,而是逐个补齐未回答的问题
先把最终报告拆成必须回答的问题,并为每一项写清范围、时间、地区、证据标准和允许标为“暂无数据”的条件。
为每个 Slot 指定优先来源、搜索词和备选路径;产品事实找官方文档,研究结论找原始论文,不能只引用搜索摘要。
Worker 按 Query Fingerprint 分工,避免重复搜索;打开原始页面,记录发布者、日期、访问时间和适用范围。
每条结论单独保存 Claim、支持它的原文位置、Source ID 和限定条件,不把整篇文章的摘要当成证据。
把支持、反对和不确定证据放在一起,检查定义、日期、样本和适用范围差异;不能静默选择更顺眼的答案。
按 Answer Slot 计算 Coverage;下一轮只补明确缺口。达到证据标准、预算耗尽或连续搜索没有新证据时停止。
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 并行搜索可以更快覆盖多个问题;但不同执行服务可能重复打开相同网页,造成额外费用。
- 优先使用官方和原始来源可以提高可信度;但用户体验和市场反馈有时只能从新闻或社区资料中获得。
- 继续搜索可能补齐缺失信息;当新增来源不再带来新结论时,继续搜索只会增加噪声和成本。
常见故障及处理方法
- 引用页面并不支持报告中的结论:删除该结论,或者重新寻找真正支持它的来源。
- 不同来源说法冲突:分别说明它们的定义、时间和适用范围,不能简单取平均值。
- 任务一直搜索无法结束:达到证据数量、费用上限,或连续几轮没有新信息时停止。
上线后要监控的指标
研究任务和网页读取任务分别排队;每个外部来源设置调用上限,并共享去重结果。
第一轮覆盖所有问题,第二轮只补缺口,避免按顺序慢慢打开每个来源。
记录搜索次数、读取页面数、工具调用、模型 Token 和人工审核时间。
限制外部连接权限,把网页内容视为不可信输入,并在引用中删除敏感信息。
监控问题覆盖率、重复来源比例、引用准确率、来源冲突和任务停止原因。
AI ENGINEER BOOTCAMP扫码或点击打开课程页面把 RAG、Agent、MCP、Memory 与 Governance 接成能上线的 Production Agentjiangren.com.au/program-course/ai-engineer-bootcamp查看课程 →
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- Evidence Ledger 的最小 schema 是什么?
- 多个 worker 如何避免重复?
- 来源冲突时 report 应该怎么写?
- 停止条件如何防止过早和无限研究?
提交设计前的检查清单
- 先定义 answer slots。
- 每个 claim 绑定 evidence。
- 重复 URL 与 query 去重。
- 冲突和缺口明确保留。
- 停止原因可解释。
RUNTIMEAI Engineering System Design耐久型 AI Agent 编排
让运行数小时的任务可以暂停、重试、等待审批并从故障中恢复
一个 Agent workflow 会等待 API、人工批准和定时器,可能运行数小时。进程重启、网络超时和重复消息都很常见,但任务不能丢,也不能重复扣款或发邮件。
系统需要提供什么
- Workflow 支持 sequence、parallel、branch、timer 和 human wait。
- 用户可以查询状态、暂停、继续、取消和重试。
- 每个副作用步骤有稳定 operation ID 与 reconciliation 状态。
性能、安全与可靠性要求
- Worker crash 后从 durable checkpoint 恢复。
- Workflow code/version 变化不会破坏正在运行的实例。
- At-least-once delivery 下仍避免重复业务副作用。
ARCHITECTURE MAPAI Engineering System Design耐久型 AI Agent 编排
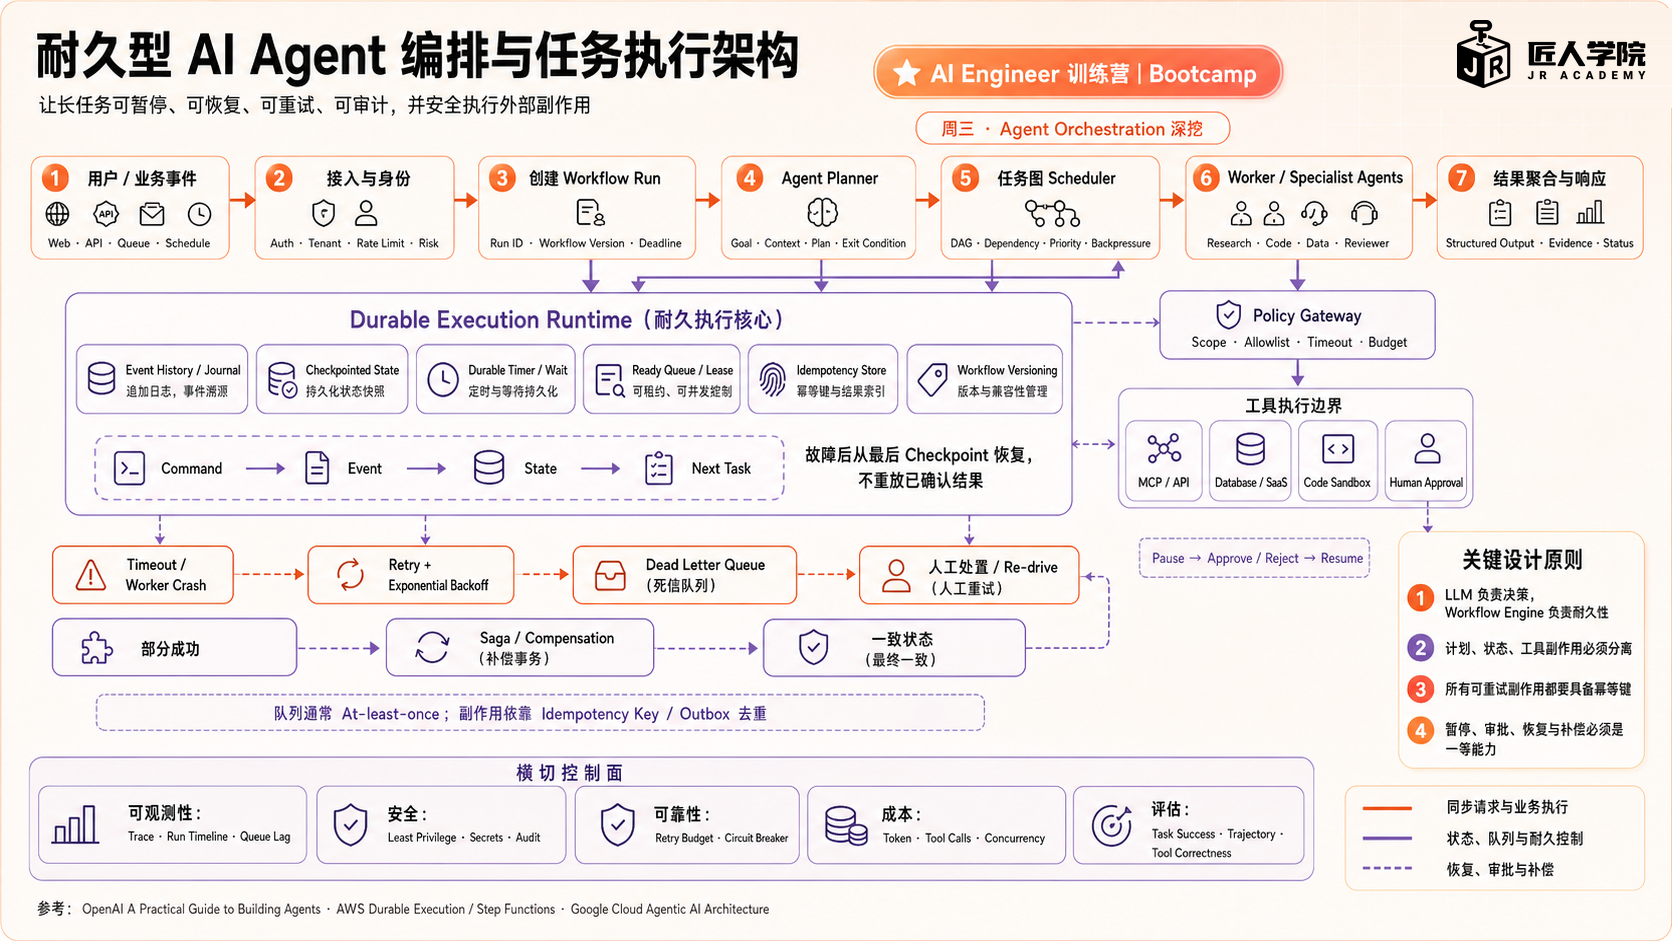 DURABLE WORKFLOW STATE MACHINEAI Engineering System Design
长任务真正需要设计的是状态转换和副作用确认
先保存 Request、Workflow Version、Tenant、Input Hash、Budget 和 Idempotency Key,再把任务放入 Queue。
Scheduler 租用下一项 Activity;Worker 只执行当前步骤,并持续写 Heartbeat、Result 和 Checkpoint。
保存待批准动作、准确参数、影响和过期时间,释放 Worker;收到绑定该 Proposal 的决定后继续。
只有可重试错误才记录 Attempt、Backoff 和 Next Run Time;保持同一个 Operation ID,避免重复副作用。
外部调用结果不明确时,按 Operation ID 查询 Provider;确认成功、补偿或转人工,禁止直接再执行。
保存最终结果、外部 Receipt、成本和失败原因,取消剩余工作、释放凭证并进入 Retention 流程。
AI ENGINEER 职业发展群微信交流群 · 顾问邀请入群讨论求职方向、项目经验与面试准备扫码添加顾问 · jiangren.com.au/contact申请入群 →
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 持久化流程可以在进程重启后继续任务;但流程代码必须保持可重放,并认真管理版本变化。
- 频繁保存进度可以从更接近故障的位置恢复;代价是会产生更多存储和事件记录。
- 流程引擎可以避免任务丢失;但付款、发信等外部操作仍需要业务系统提供防重复能力。
常见故障及处理方法
- 外部操作成功后执行进程崩溃:使用操作编号查询目标系统,确认状态前不能直接重试。
- 同一任务反复失败:达到重试上限后放入失败队列,并保留完整历史供人工排查。
- 新版本流程与运行中的旧任务不兼容:旧任务继续使用原流程,新任务才使用新流程。
上线后要监控的指标
按企业、优先级和任务类型拆分队列;执行服务本身不保存状态,可以按需增加实例。
用户正在等待的步骤和后台任务使用不同队列;定时等待不占用执行进程。
统计任务历史、进度保存、执行时间、失败重试和外部 API 调用费用。
每个执行步骤只获得当前操作需要的短期权限,人工批准必须绑定具体参数。
监控任务运行时长、排队时间、尝试次数、最近进度、外部操作和卡住原因。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- Exactly-once 为什么不能只靠 queue?
- 外部调用成功但 checkpoint 失败怎么办?
- 怎样升级仍在运行的 workflow?
- Human approval 等待时如何节省资源?
提交设计前的检查清单
- 任务状态持久化。
- 副作用有 operation ID。
- Retry policy 按错误类型区分。
- 未知结果进入 reconciliation。
- 取消和超时有补偿路径。
RUNTIMEAI Engineering System DesignAI Agent 工具执行沙箱与审批
所有工具调用先经过权限判断、短期凭证和隔离执行环境
平台服务 10,000 个内部 Agent 和 500 种工具,包括查询、发邮件、修改 CRM、数据库写入和支付。低风险调用希望额外开销 p95 小于 300ms,高风险动作必须审批。
系统需要提供什么
- Tool registry 描述 schema、owner、risk、side effect、idempotency 和 required scope。
- 每次调用根据 actor、tenant、purpose、resource 和 arguments 重新授权。
- 高风险 mutation 展示准确参数,获得 approval 后才执行。
性能、安全与可靠性要求
- Agent 不持有永久 credential。
- Sandbox 限制 filesystem、process、network、CPU、memory 和 duration。
- 审计能区分 proposal、approval、execution、result 与 compensation。
ARCHITECTURE MAPAI Engineering System DesignAI Agent 工具执行沙箱与审批
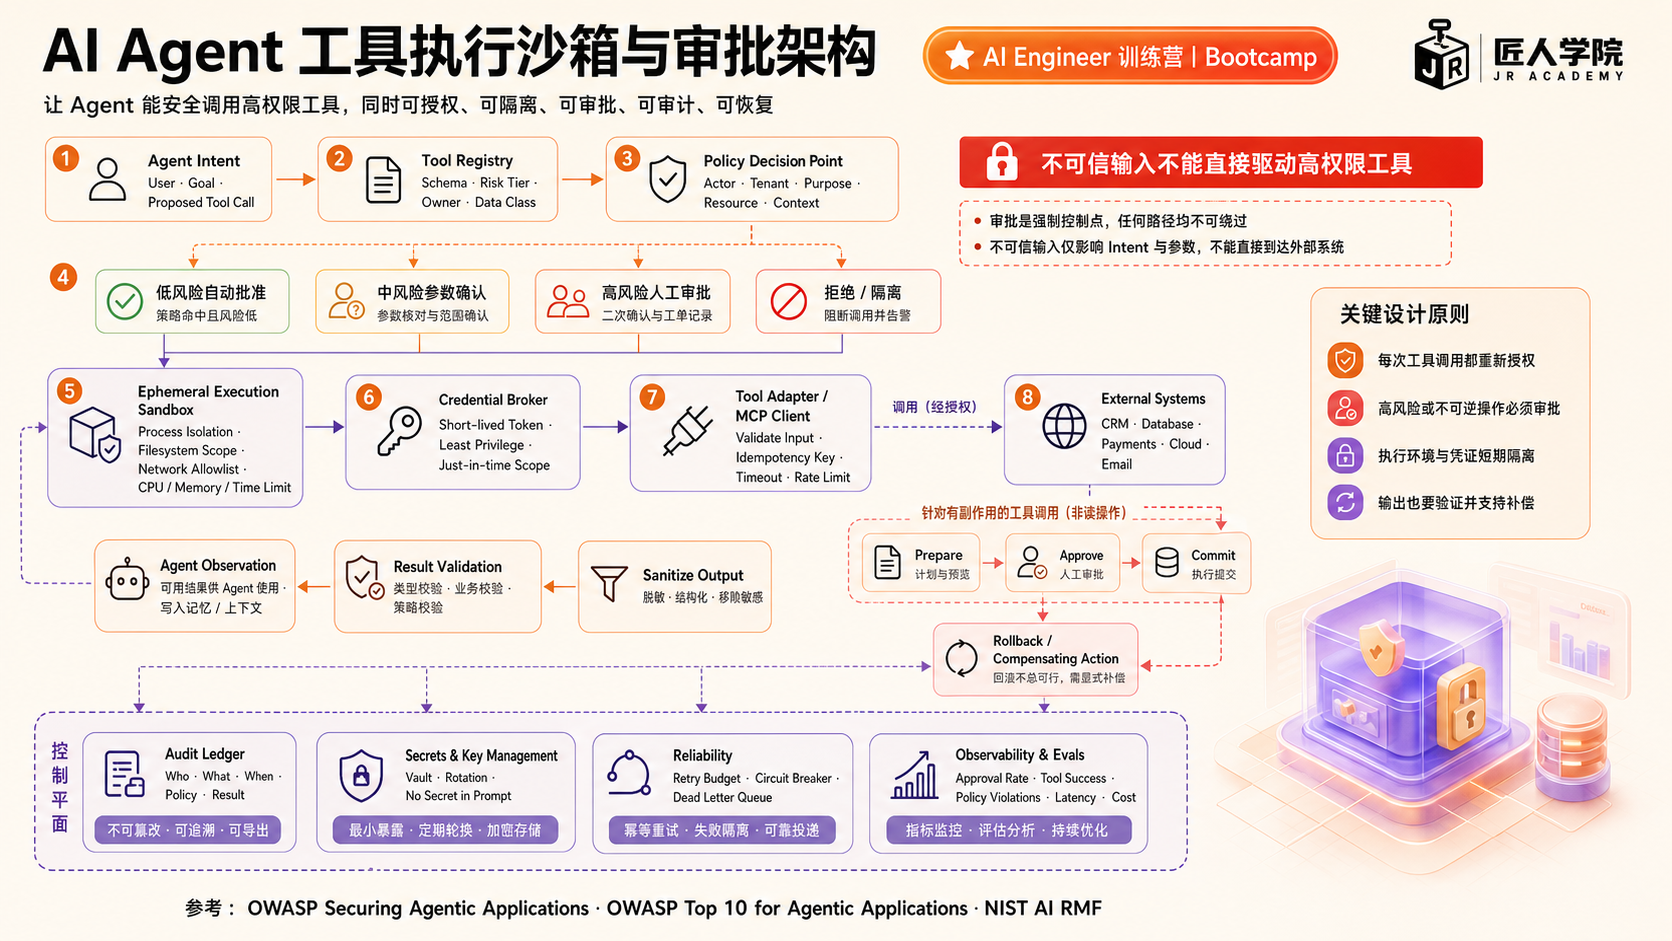 AI ENGINEER BOOTCAMP扫码或点击打开课程页面把 RAG、Agent、MCP、Memory 与 Governance 接成能上线的 Production Agentjiangren.com.au/program-course/ai-engineer-bootcamp查看课程 →
TOOL AUTHORIZATION DECISION TREEAI Engineering System Design
一次 Tool Call 先做风险决定,再决定执行、拒绝还是等待人工
Tool 必须存在于 Registry;参数类型、必填字段和枚举值全部通过校验,未知字段默认拒绝。
从可信 Session 读取用户、Tenant、角色和用途,不能采用模型在 Prompt 中自报的身份。
区分只读、可撤销写入和不可逆动作,并评估金额、数据敏感度、Blast Radius 与恢复能力。
逐项检查资源 ID、路径、收件人、金额、时间和数量是否在授权范围,防止参数注入和范围扩大。
返回可理解的拒绝原因并写 Audit Event;不签发凭证,也不连接目标系统。
仅对低风险且范围明确的动作签发一次性短期凭证;在 Sandbox 执行,随后从 Provider Read-back。
向用户展示将执行的准确动作、参数和影响;批准绑定 Proposal Hash 与过期时间,任何参数变化都要重新确认。
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 所有工具通过统一入口便于管理权限和记录操作;但入口需要高可用,否则会拖慢或阻断所有工具。
- 要求人工确认可以控制高风险操作;如果普通操作也频繁弹出确认,用户会习惯性点击同意,反而降低安全性。
- Container 可以隔离大多数普通任务;运行不可信代码或服务多个企业时,VM 隔离更强但启动更慢、成本更高。
常见故障及处理方法
- 网页或文档诱导模型调用高权限工具:权限判断只相信登录身份和结构化参数,不能相信模型生成的理由。
- 用户批准后调用参数被更换:批准记录必须绑定完整参数和有效期,参数变化后需要重新确认。
- 支付请求超时:使用操作编号查询支付状态,仍无法确认时交给人工处理。
上线后要监控的指标
工具登记和权限管理与实际执行分开扩展;不同风险和工具类型使用独立执行资源。
低风险权限规则可以缓存,但缓存必须绑定企业和规则版本。
统计隔离环境启动、外部系统调用、人工审批和撤销操作的费用。
检查短期凭证只能访问目标系统,禁止把凭证转交给其他服务,并限制外部网络。
记录允许或拒绝的原因、批准人、凭证范围、执行结果和实际产生的数据修改。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- 为什么 Sandbox 与 Credential Broker 要分开?
- Approval 应绑定哪些字段?
- 副作用调用怎样安全 retry?
- 如何抵御 prompt injection 驱动高权限工具?
提交设计前的检查清单
- Model 只提交 proposal。
- 每次调用重新授权。
- 凭证短期且 audience-bound。
- 审批绑定不可变参数。
- 未知副作用不自动重试。
RUNTIMEAI Engineering System Design企业级 AI Gateway 与多模型路由
统一接入多个模型供应商,并按质量、延迟、成本和合规要求路由
同一产品需要多个 model/provider:低延迟 chat、复杂推理、embedding、vision 和受地域限制的 workload。团队希望统一认证、预算、fallback 与审计。
系统需要提供什么
- 客户端使用稳定 contract,不直接依赖 provider-specific API。
- Routing 根据 capability、region、risk、quality、latency 和 budget。
- Fallback 只在语义兼容且数据边界允许的候选之间发生。
性能、安全与可靠性要求
- Gateway 不记录 secret 或不必要的 raw prompt。
- Provider 故障被隔离,单一模型不能耗尽全部 capacity。
- Routing decision 可解释并绑定 policy version。
AI ENGINEER 职业发展群微信交流群 · 顾问邀请入群讨论求职方向、项目经验与面试准备扫码添加顾问 · jiangren.com.au/contact申请入群 →
ARCHITECTURE MAPAI Engineering System Design企业级 AI Gateway 与多模型路由
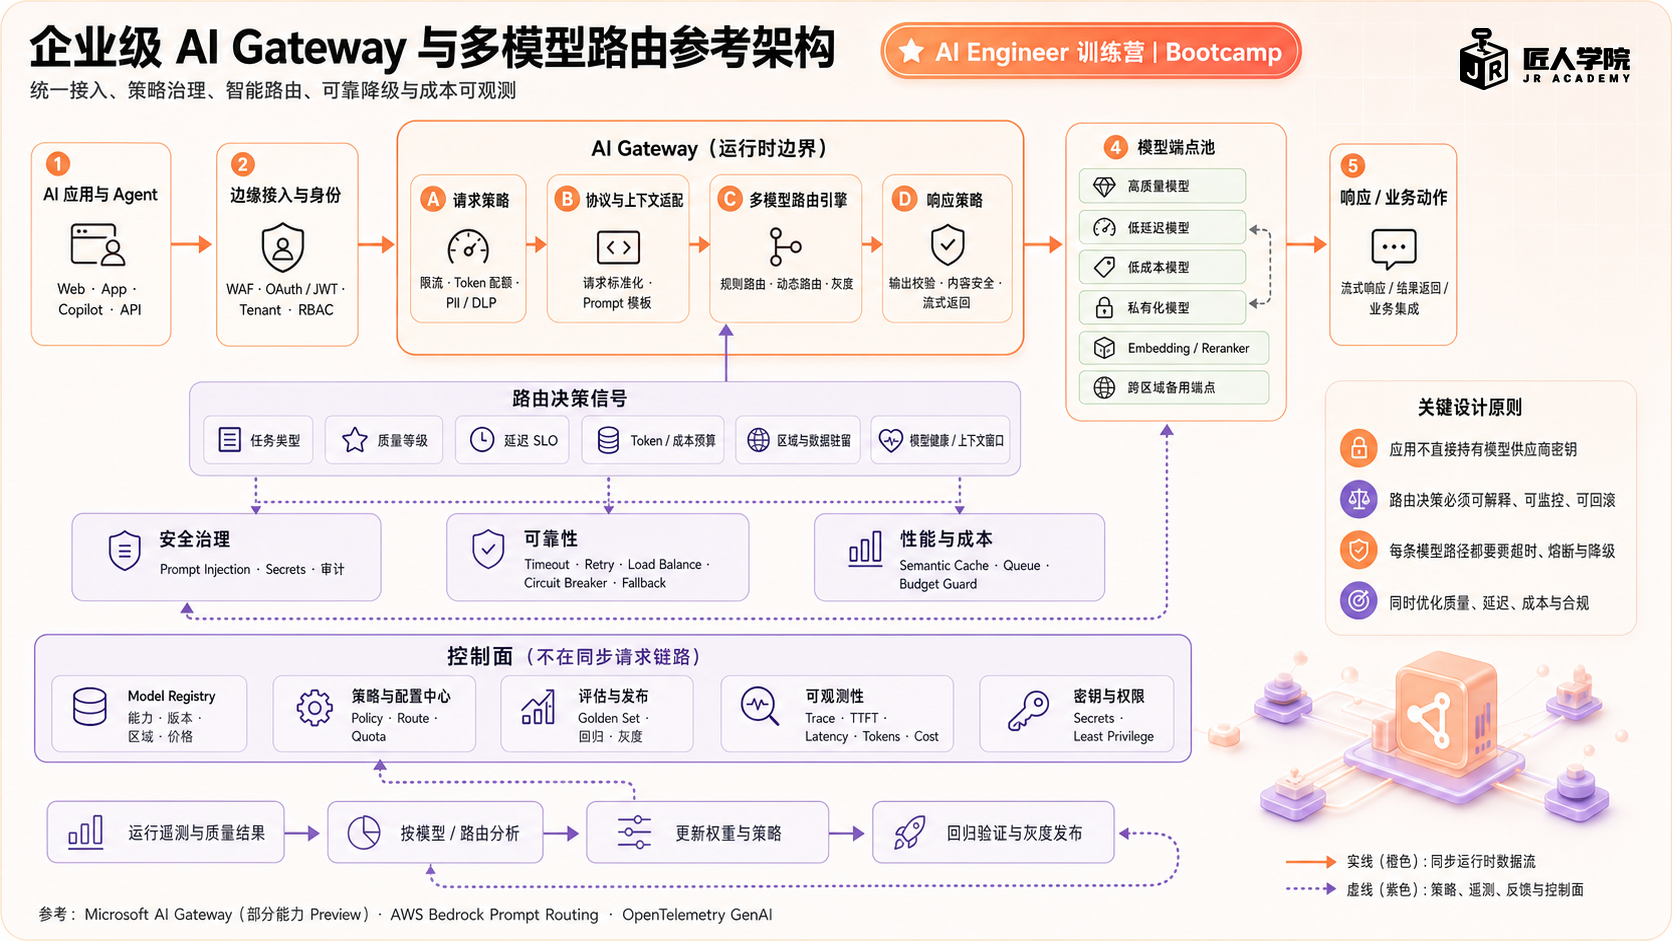 MODEL ROUTING DECISION TREEAI Engineering System Design
模型路由先排除不合规候选,再在可用集合里优化 SLO 和成本
候选模型必须支持所需 modality、context length、tool calling 和 structured output contract。
检查数据驻留、retention、训练使用限制和当前请求的数据分级;不合规候选直接移除。
用本次请求的成本上限、deadline、TTFT 与 availability class 筛选,不使用未经验证的性能数字。
读取实时错误率、限额、区域容量与 circuit breaker 状态,避免继续把流量送入故障 Provider。
在合规候选中,选择满足 SLO 且质量评分最高的模型;记录 model、provider 与 policy version。
只切到 contract、数据区域和 retention policy 都兼容的候选;已经开始 streaming 时显式重启。
没有合规候选或 Policy 状态不明时不降级绕过;返回拒绝原因以及是否可以稍后重试。
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 统一请求格式让应用更容易切换模型供应商;但某些供应商独有功能可能无法完整使用。
- 主模型不可用时切换备用模型可以提高可用性;但回答质量、费用和数据处理地区可能发生变化。
- 先用便宜模型、失败后再用更强模型可以节省费用;代价是部分请求会调用多次,等待时间更长。
常见故障及处理方法
- 供应商返回限流错误:只重试有限次数,或切换到已经批准的备用模型,不能同时调用大量模型。
- 流式回答中途断开:明确告诉客户端结果不完整,不能假装由另一个模型无缝接着生成。
- 路由规则缓存过期:涉及敏感数据或高风险操作时停止请求,等待最新规则。
上线后要监控的指标
Gateway 可以增加实例;用户额度、模型健康状态和路由信息按区域分开保存。
模型选择必须快速完成,不能在每次请求中运行耗时的在线评测。
记录输入输出 Token、缓存节省、失败重试和备用模型带来的额外费用。
供应商密钥只保存在 Adapter 或凭证服务中;模型选择必须考虑数据地区和敏感等级。
记录为何选择当前模型、哪些候选被排除、供应商耗时和错误、是否切换备用模型及最终费用。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- 什么情况下不能 fallback?
- Canonical schema 如何兼顾 provider 特性?
- Routing policy 如何避免震荡?
- Streaming 已输出一半时失败怎么办?
提交设计前的检查清单
- 客户端不接 provider key。
- 候选先经过合规过滤。
- Fallback 语义明确。
- Route 决策有 version。
- Usage 与 error 可按 provider/model/tenant 分析。
AI ENGINEER BOOTCAMP扫码或点击打开课程页面把 RAG、Agent、MCP、Memory 与 Governance 接成能上线的 Production Agentjiangren.com.au/program-course/ai-engineer-bootcamp查看课程 →
RUNTIMEAI Engineering System Design高可用 LLM 推理与 GPU 调度
通过排队、批处理、缓存和故障隔离提高 GPU 利用率与服务稳定性
自托管模型需要同时服务短 chat 和长 context 请求。GPU 昂贵且启动慢,单机故障会丢失 KV cache;系统还要在 throughput 与 time-to-first-token 之间取舍。
系统需要提供什么
- 提供 streaming inference、admission control、cancellation 和 model version routing。
- 根据 request shape 调度 replica,并支持 rolling rollout。
- 在 GPU/node/zone 故障时重新排队未完成请求。
性能、安全与可靠性要求
- 定义 TTFT、inter-token latency、tokens/s 与 queue time SLO。
- OOM 或超长请求不能拖垮整个 worker pool。
- Model weights、runtime 与 tokenizer version 一致。
ARCHITECTURE MAPAI Engineering System Design高可用 LLM 推理与 GPU 调度
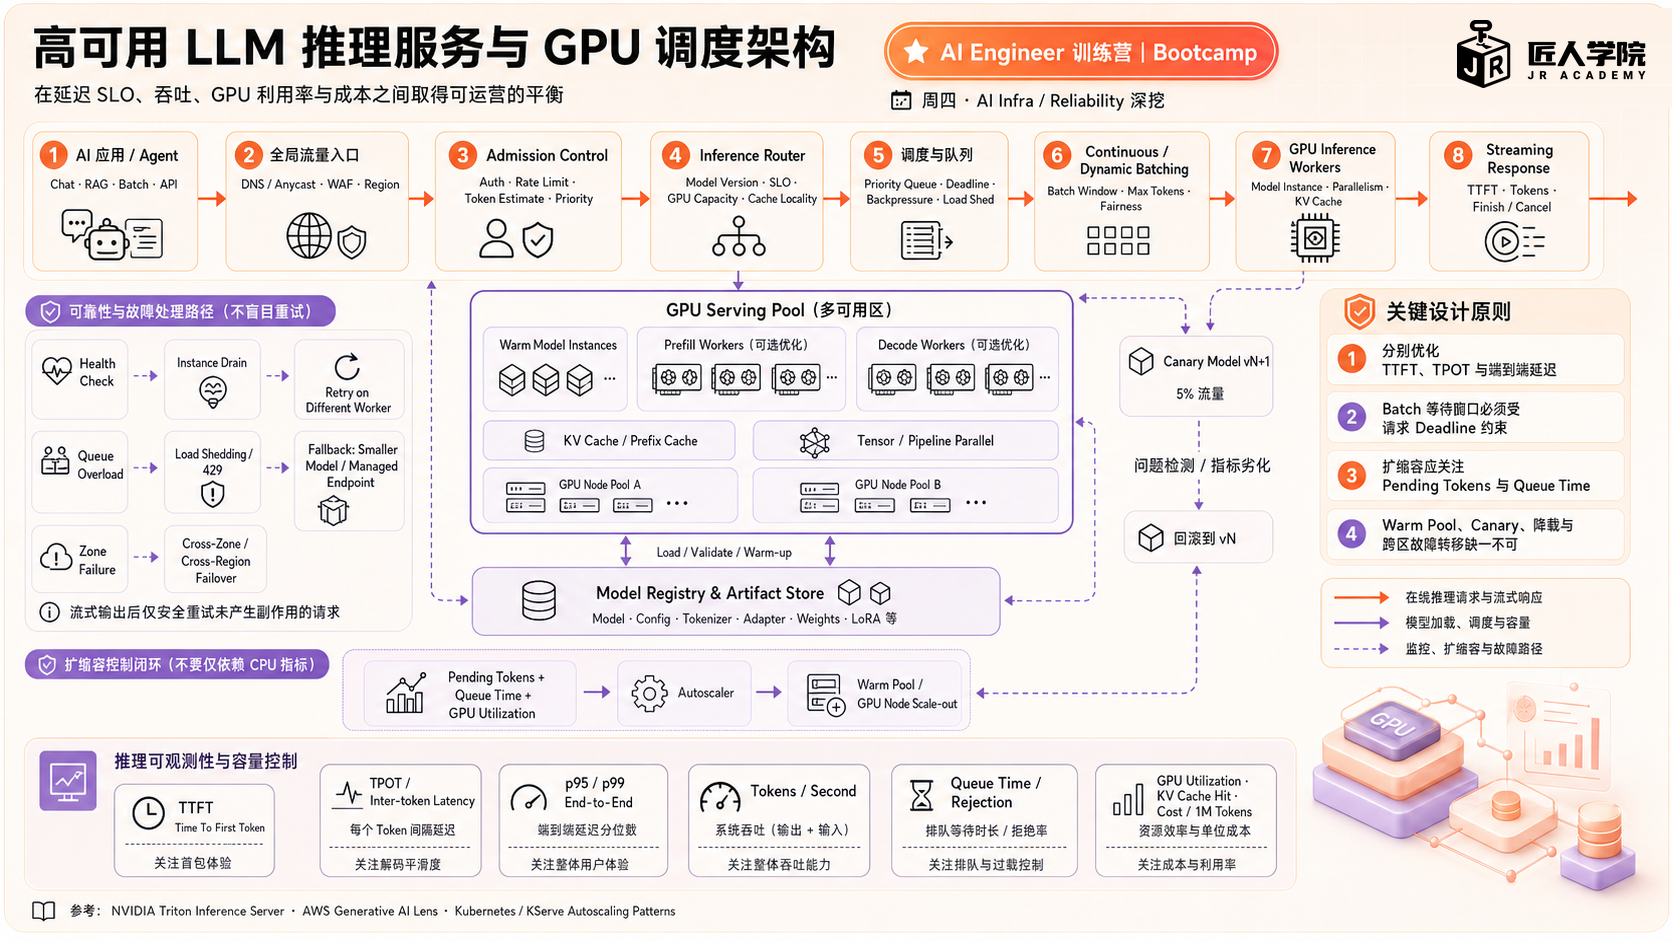 GPU INFERENCE SERVING PATHAI Engineering System Design
GPU Serving 要同时看排队、KV Cache、批处理和取消传播
请求到达后,入口先确认要使用的模型、预计 Token 数、优先级和最长等待时间。
容量控制器查看排队长度和 GPU 余量;系统繁忙时会拒绝低优先级请求或使用已批准的降级方案。
调度器选择已经加载正确模型、并且有足够显存处理该请求的服务实例。
推理引擎把形状相近的请求组成批次,先处理输入,再持续生成输出 Token。
生成的 Token 实时发送给客户端;用户取消请求后,GPU 会尽快停止无用计算。
健康检查发现异常实例后立即停止分配新请求;尚未开始的请求可以转移,已开始的请求按规则处理。
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 把更多请求放进同一批次可以提高 GPU 利用率;但单个请求需要等待更久才能开始。
- 优先把请求发到已有 KV Cache 的实例可以减少重复计算;但可能造成少数实例过载。
- 把一个大模型拆到多台机器可以突破单机显存限制;代价是任何一台机器或网络故障都会影响整个请求。
常见故障及处理方法
- GPU 显存不足:在接收请求前估算需要的显存,并把超长请求放入独立资源池。
- 服务实例崩溃:明确结束当前输出;只有可以安全重复的请求才自动转到其他实例。
- 模型组件版本不一致:一次发布必须锁定模型权重、Tokenizer 和推理环境的完整版本。
上线后要监控的指标
按模型和请求长度建立不同资源池;模型如何跨 GPU 拆分由模型大小和网络条件决定。
分别监控排队、处理输入和生成输出的时间,并为短请求预留容量。
关注 GPU 使用率、每秒生成 Token 数、备用容量和跨地区网络费用。
验证模型和容器来源;不同企业的 Prompt 不能写入共享调试日志。
监控排队长度、首个 Token 等待时间、连续 Token 间隔、批次大小、缓存占用和显存错误。
AI ENGINEER 职业发展群微信交流群 · 顾问邀请入群讨论求职方向、项目经验与面试准备扫码添加顾问 · jiangren.com.au/contact申请入群 →
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- Continuous batching 对 latency 有什么影响?
- 为什么 round-robin 可能破坏 KV cache locality?
- 超长 context 怎样隔离?
- 模型升级如何 rollback?
提交设计前的检查清单
- 指标拆分到 queue/prefill/decode。
- Admission control 先于 GPU。
- 请求按 shape 分池。
- 版本 manifest 完整。
- 失败 stream 不伪装成功。
RUNTIMEAI Engineering System Design实时 Voice AI Agent
把语音输入、实时推理、工具调用、打断和断线恢复连成低延迟会话
设计一个实时客服 Voice Agent。用户可以插话,通话中会检索账户信息并调用工具;网络抖动、静音检测和错误工具结果都不能让 Agent 继续误导用户。
系统需要提供什么
- 支持双向音频、streaming transcript、barge-in 和 session control。
- Tool call 前后保持 conversation state,并向用户表达等待或失败。
- 敏感操作需要额外身份确认和 approval。
性能、安全与可靠性要求
- 端到端延迟拆成 capture、network、model、tool 与 playback。
- 断线可以恢复 session,但不能重复执行 side effect。
- 音频、transcript 与 recording retention 由 consent 控制。
ARCHITECTURE MAPAI Engineering System Design实时 Voice AI Agent
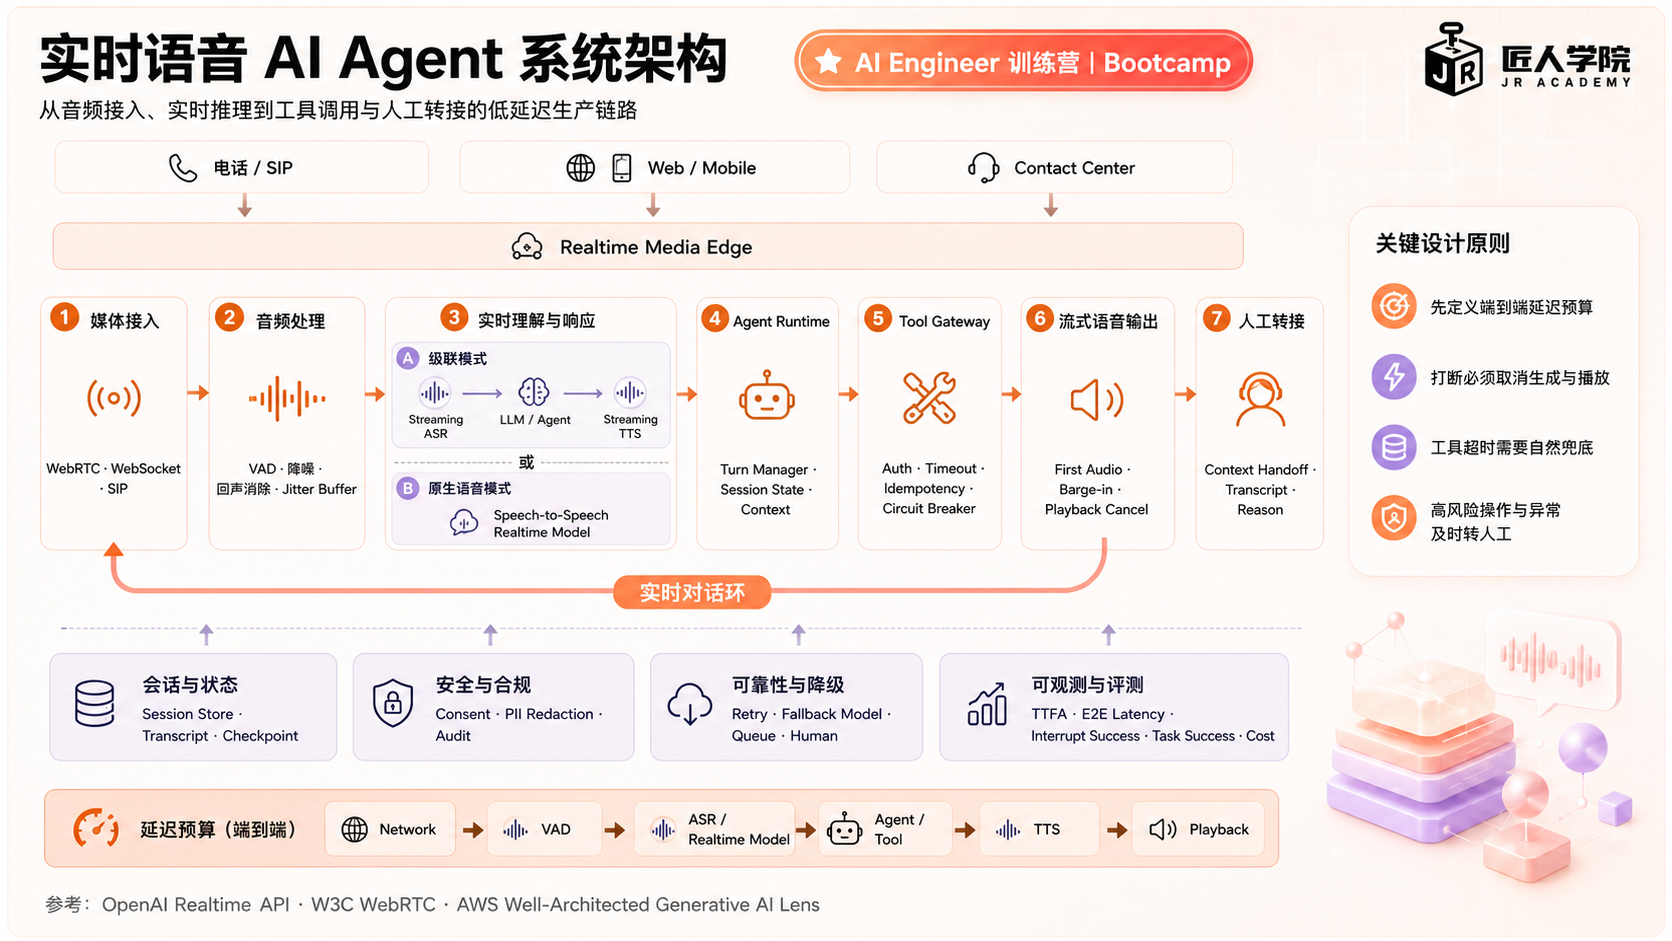 VOICE LATENCY & INTERRUPTION TIMELINEAI Engineering System Design
Voice Agent 的设计单位是一轮实时交互,不是一条普通 API 请求
客户端读取 Mic,执行降噪和回声消除;VAD 判断开始与停顿,并给音频片段加时间戳和 Turn ID。
WebRTC 传实时音频,WebSocket 传 Transcript、Tool 和控制事件;Sequence Number 用于检测丢包与重连。
Realtime Model 边接收边生成 Partial Transcript、意图和回答;未 Finalize 的文字不能直接写入长期 Memory。
Tool Gateway 校验工具、参数和权限;付款、修改账户等高风险动作必须获得绑定参数的用户确认。
服务端持续生成音频 Chunk,客户端维护 Playback Buffer,并记录哪些音频已发送、哪些真的播放给用户。
检测到新语音后立即停止本地播放,取消仍在生成的音频和未开始的 Tool Call,再同步新的 Turn State。
AI ENGINEER BOOTCAMP扫码或点击打开课程页面把 RAG、Agent、MCP、Memory 与 Governance 接成能上线的 Production Agentjiangren.com.au/program-course/ai-engineer-bootcamp查看课程 →
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 在服务器判断用户是否说完,所有设备行为更一致;在客户端判断可以减少上传流量,但不同手机和麦克风表现差异更大。
- 模型越早开始回答,用户感觉越快;但用户继续说话时,更容易出现打断和重新生成。
- 保存原始音频有助于质量检查;但隐私风险和存储成本都明显增加。
常见故障及处理方法
- 网络不稳定:使用短缓冲和断线重连;已经确认成功的工具操作不能重复执行。
- 系统误以为用户已经说完:允许用户随时插话,并立即停止尚未播放的回答。
- 业务工具响应太慢:先告诉用户仍在处理,再转为后台任务或人工客服。
上线后要监控的指标
语音连接优先使用离用户较近的地区;会话、模型和工具服务分别扩容。
重点监控用户说完到听见第一段回答的时间,而不只看模型耗时。
分别统计音频 Token、语音转文字、模型调用、工具调用和录音存储费用。
录音前获得同意,敏感操作确认用户身份,并隐藏按键号码和个人信息。
监控丢包率、每轮对话耗时、用户打断次数、工具等待时间、转人工比例和任务结果。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- Barge-in 时如何取消正在生成和播放的内容?
- 断线重连怎样避免重复付款?
- 哪些音频可以保存?
- Voice latency budget 如何拆?
提交设计前的检查清单
- Media 与 control event 都有 session ID。
- 打断能传播到 model 与 playback。
- Tool side effect 幂等。
- Consent 可审计。
- 慢工具有用户可理解的降级。
RUNTIMEAI Engineering System Design多模态文档智能处理
保留文档的页码、版面、表格和字段位置,让结果可以回到原文
平台处理 2,000 万份、15 种格式的文档。关键表格字段需要 99% accuracy,结果必须定位到原始页码和坐标,新文档 30 分钟内可检索。
系统需要提供什么
- 安全接收 PDF、Office、图片和扫描件,并识别格式与质量。
- 统一 Document Model 保存页、block、table、figure、coordinate 与 source span。
- 低置信字段进入 human review,修正结果用于后续 evaluation。
性能、安全与可靠性要求
- 上传与解析任务幂等;同一版本不会重复写 index。
- 原始文件、解析结果和模型版本可追溯。
- 恶意文件和超大文档不能耗尽 parser pool。
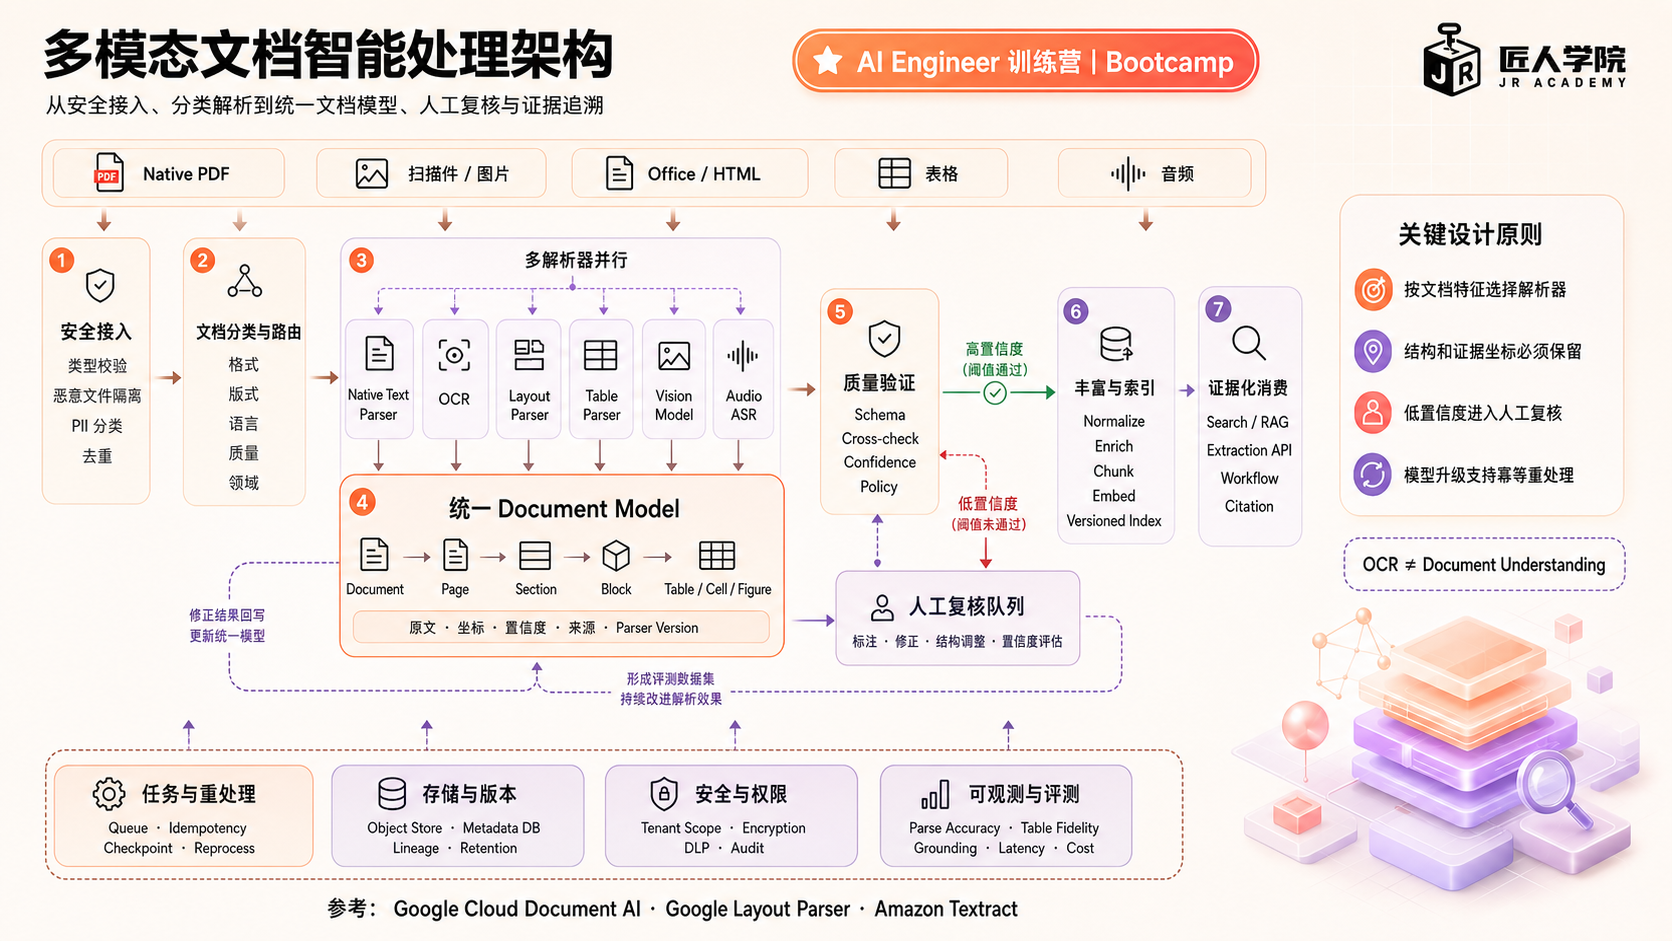
ARCHITECTURE MAPAI Engineering System Design多模态文档智能处理
 AI ENGINEER 职业发展群微信交流群 · 顾问邀请入群讨论求职方向、项目经验与面试准备扫码添加顾问 · jiangren.com.au/contact申请入群 →
DOCUMENT ROUTING & CONFIDENCE GATESAI Engineering System Design
不同文档应走不同解析路径,最后汇合到统一 Document Model
有可用文字层、标题和表格结构;先检查加密、损坏、宏和文件类型是否与声明一致。
页面只有像素或文字层不可信;先识别语言、旋转方向、分辨率与扫描质量。
多栏、表单、图表、手写内容或阅读顺序不明确,需要理解版面关系。
直接提取正文、Heading、Metadata 和表格,速度快且结果稳定,同时保留字符 Offset。
先校正旋转和噪声,再识别文字与区块;每个 Block 返回 Bounding Box 和 Confidence。
只处理复杂页面,解释表格、Figure 与文字之间的关系;输出仍必须指回原始页面区域。
统一保存 Document / Version / Page / Block ID,以及 Text、Table、Figure、Coordinate、Source Span、Parser Version 与 Confidence。
Schema、Coverage、ACL 和质量检查通过后,写入新 Index Version;验证完成才切换 Search / RAG Alias。
只把低置信字段送人工复核,并同时展示原始页面裁剪和解析结果;修正内容生成新的 Version。
损坏、加密、格式伪装或含危险 Payload 的文件进入 Quarantine,记录原因但不阻塞同批其他文档。
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 通用多模态模型可以处理更多文件格式;固定格式的表单使用专用解析器通常更稳定、费用也更低。
- 提高图片分辨率可以识别更小的文字;但处理时间和模型费用都会增加。
- 提高自动通过的置信度门槛可以减少错误;同时会把更多文件送到人工复核队列。
常见故障及处理方法
- 表格跨页后结构断裂:保留页码和版面关系,尝试连接相邻页面,并把不确定结果交给人工复核。
- 更换模型后字段结果发生变化:用新模型处理一批固定样本进行比较,不能直接覆盖旧数据。
- 人工复核积压:按照字段风险安排优先级,不能为了清空队列降低关键字段的准确率要求。
上线后要监控的指标
按文件类型、页数和是否需要 OCR 分配处理资源;超大文件单独限流。
分别统计排队、解析、人工复核和写入索引的时间。
记录处理页数、OCR、模型调用、人工复核时间和索引容量。
新文件先隔离并扫描,原始文件加密保存,对敏感字段进行遮盖。
监控解析成功率、字段准确率、置信度变化、人工队列等待时间和索引更新时间。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- 统一 Document Model 最少要保存什么?
- 99% accuracy 的 denominator 怎么定义?
- 低置信字段如何进入 review?
- 模型升级如何幂等重处理?
提交设计前的检查清单
- 原始文件不可变。
- Document Model 保留坐标。
- 字段有 confidence 与 source。
- 关键字段有 human gate。
- index 绑定 document/model version。
TRUSTAI Engineering System Design多租户 AI 数据隔离与隐私
确保文件、Memory、索引、日志和备份都不会跨租户泄漏
一个 SaaS AI 平台服务多个企业客户,共享 gateway、model 和部分 runtime,但 prompt、files、memory、vector index、trace 与 evaluation data 不能跨租户泄漏。
系统需要提供什么
- 每个请求绑定 authenticated tenant 与 user identity。
- 数据 copy 有 tenant、purpose、retention、region 和 encryption context。
- 客户可以导出、删除并验证自己的数据。
性能、安全与可靠性要求
- 任何缺失 tenant context 的访问 fail closed。
- 共享资源的 cache、queue 和 log 不产生 cross-tenant side channel。
- 删除能传播到 index、backup、trace 和 training/eval dataset。
AI ENGINEER BOOTCAMP扫码或点击打开课程页面把 RAG、Agent、MCP、Memory 与 Governance 接成能上线的 Production Agentjiangren.com.au/program-course/ai-engineer-bootcamp查看课程 →
ARCHITECTURE MAPAI Engineering System Design多租户 AI 数据隔离与隐私
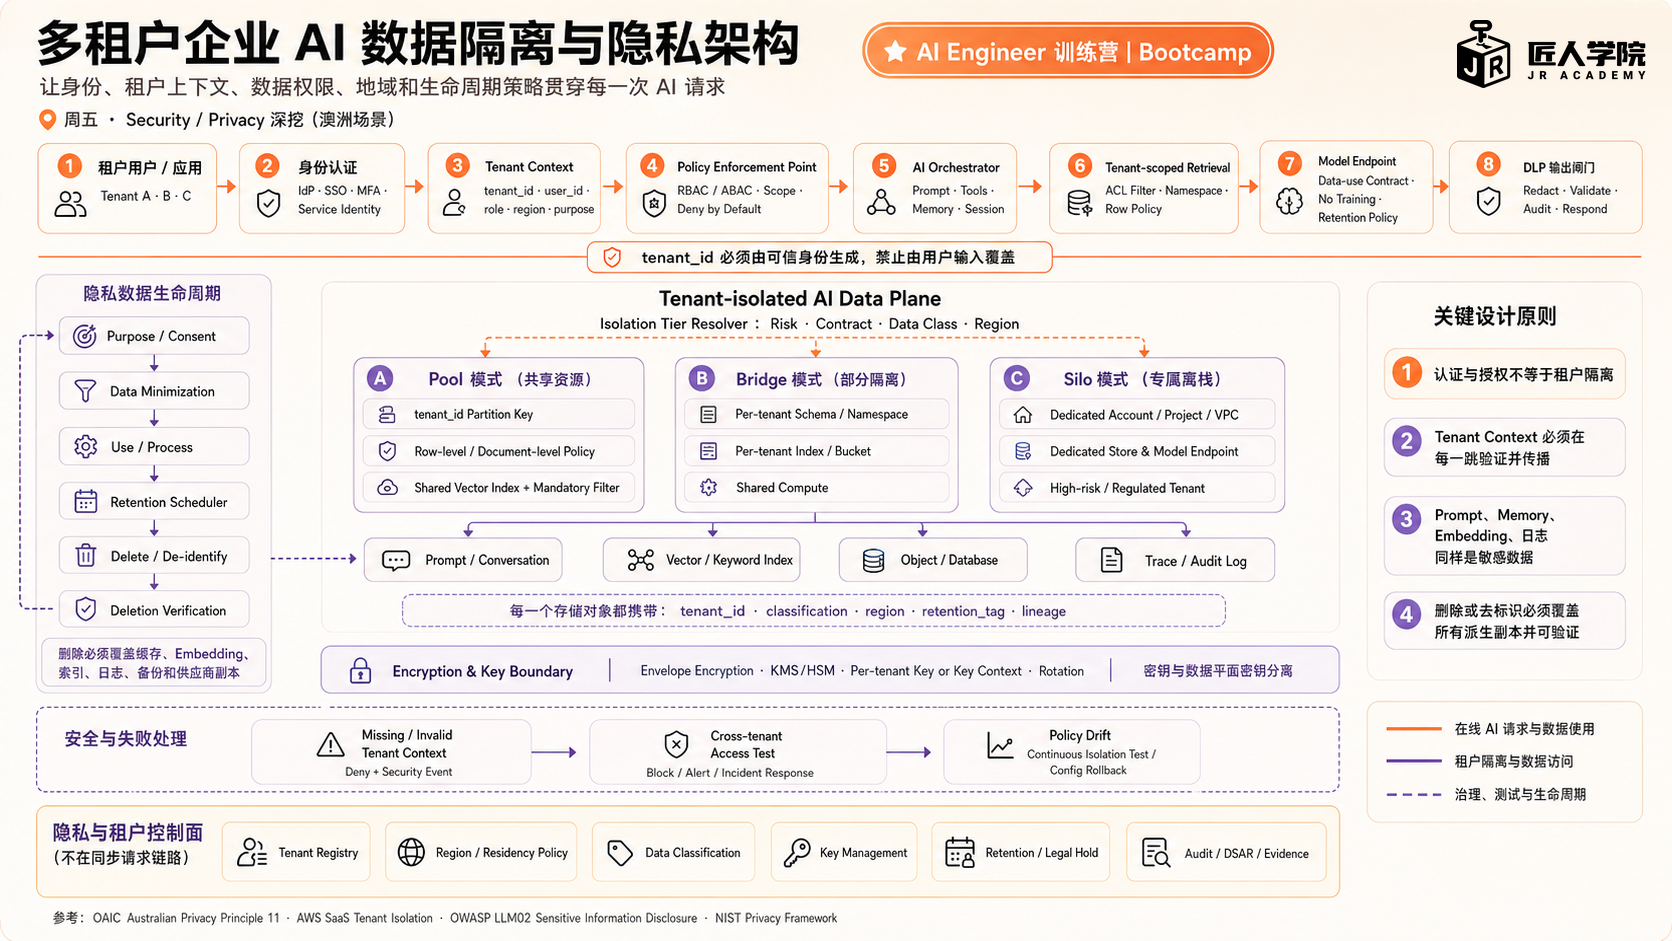 TENANT ISOLATION OPTIONSAI Engineering System Design
隔离方案要根据监管、数据敏感度和负载规模选择
| 模式 | 怎样隔离 | 什么时候选择 | 代价与主要风险 |
|---|---|---|---|
| Silo · 独立部署 | 每个 Tenant 使用独立 App、Worker、Database、Vector Index 和 Encryption Key;升级与扩容也单独执行。 | 强监管、数据驻留要求、超大客户,或工作负载不能与其他租户共享资源。 | 成本和运维复杂度最高,版本容易漂移;但故障和数据泄漏的 Blast Radius 通常限制在单个 Tenant。 |
| Bridge · 共享控制面 | Gateway、配置和发布系统共享;业务数据、Index、Key,必要时 Worker Pool 按 Tenant 分开。 | 需要企业级数据隔离,但仍希望统一治理、路由、监控和版本发布。 | 成本居中;Control Plane 故障会影响多个租户,错误的 Tenant-to-Store 路由可能造成跨租户访问。 |
| Pool · 全面共享 | 服务、表、Index 和 Queue 共享;每条记录强制 Tenant ID,并使用 RLS、Partition 与 Tenant-aware Cache Key。 | 大量中小客户、策略相近、单租户流量较小,希望提高资源利用率。 | 单位成本最低;遗漏一次 Tenant Predicate 就可能泄漏数据,还要处理 Noisy Neighbor 和共享容量故障。 |
| Hybrid · 分级组合 | Placement Registry 根据 Tenant、Data Class、Region 和风险,把不同数据或工作负载放入 Silo、Bridge 或 Pool。 | 平台同时服务普通客户、受监管客户和热点大客户,需要逐步升级隔离等级。 | 最灵活但路由、迁移和删除最复杂;Placement 配置本身成为关键状态,必须版本化并持续测试。 |
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 每家企业使用独立系统,数据隔离最强;但服务器、部署和运维成本也最高。
- 多家企业共享数据库可以降低成本;但每一次查询都必须强制带上企业条件,任何遗漏都可能泄漏数据。
- 多家企业通常可以共享同一个模型;缓存和 Context 包含用户内容,需要更严格的隔离。
常见故障及处理方法
- 请求中缺少企业信息:立即拒绝请求,不能自动使用某个默认企业。
- 缓存编号没有包含企业:清空受影响缓存,检查访问日志,并确认是否有数据被其他企业读取。
- 删除操作只清理了主数据库:根据数据清单继续删除索引、缓存和备份;暂时无法删除的介质必须明确记录。
上线后要监控的指标
根据客户风险选择完全独立或共享资源;高流量企业设置单独额度和资源上限。
权限和密钥查询可以缓存,但缓存必须绑定企业和规则版本。
计算数据隔离增加的重复索引、加密密钥、备份和预留容量费用。
身份、加密和网络规则都必须绑定企业;系统中不存在默认企业。
指标、日志和请求链路包含不可反推出敏感信息的企业编号,不能记录原始敏感内容。
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- Silo、pool、bridge 三种 isolation 怎么选?
- Vector index 怎样做 tenant isolation?
- 共享 cache 最大风险是什么?
- Backup 里的删除请求怎么处理?
提交设计前的检查清单
- 请求始终有 tenant context。
- 每个 copy 进入 data inventory。
- Cache key 包含 tenant。
- 删除有传播与 read-back。
- 缺失身份时 fail closed。
AI ENGINEER 职业发展群微信交流群 · 顾问邀请入群讨论求职方向、项目经验与面试准备扫码添加顾问 · jiangren.com.au/contact申请入群 →
TRUSTAI Engineering System Design生产级 AI Agent 评估、安全与治理
用离线评测、线上监控、审批和审计控制 AI Agent 的发布风险
企业已经有多种 Agent。安全 team 关心 prompt injection 和越权,产品 team 关心 task success,财务关心 cost,业务 owner 关心错误动作。需要一个共同 release gate。
系统需要提供什么
- 建立按 use case 和 risk tier 分类的 evaluation suite。
- 同时评测 model output、retrieval、tool decision 和最终业务 outcome。
- Incident 可以关联 agent/model/prompt/tool/policy version 并触发 rollback。
性能、安全与可靠性要求
- Evaluation dataset 有来源、consent、版本与访问控制。
- 自动 judge 的局限、置信度和人工抽查可见。
- Policy exception 有 owner、expiry 和 review。
ARCHITECTURE MAPAI Engineering System Design生产级 AI Agent 评估、安全与治理
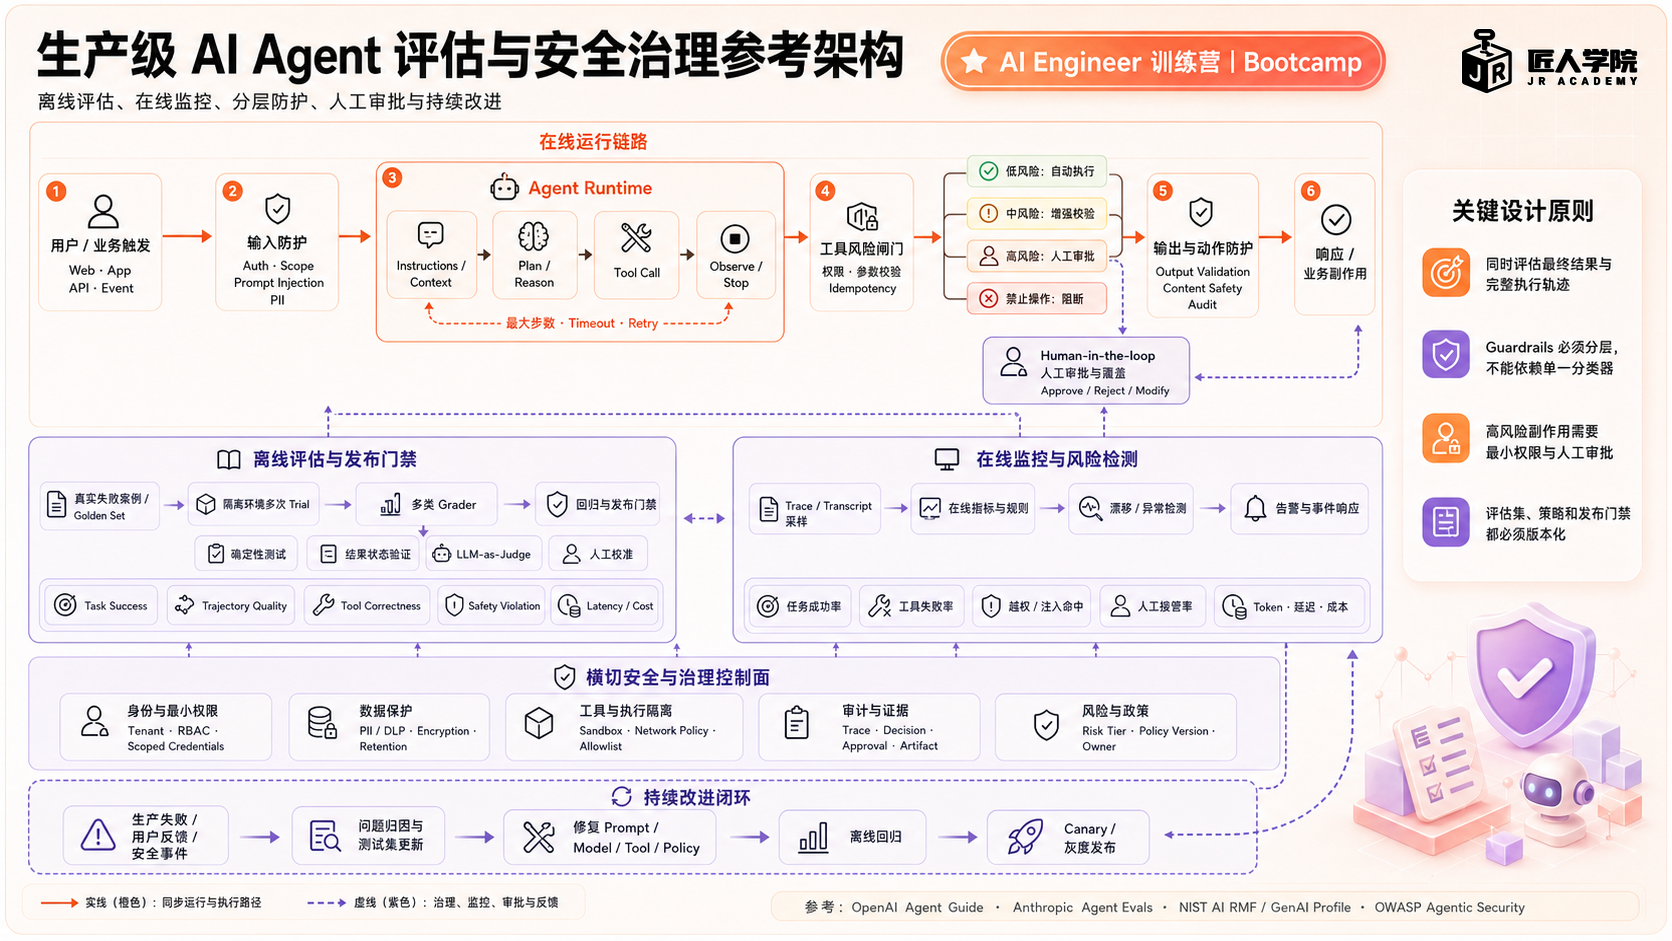 RISK-TIERED EVALUATION & RELEASE GATESAI Engineering System Design
治理不是最后盖章,而是按风险决定需要哪些证据才能发布
例如内部搜索回答、摘要草稿或建议;不修改业务状态,用户能够立即发现并纠正错误。
例如创建工单、更新 CRM、安排任务或调用有副作用的内部工具;错误会影响一组用户。
例如付款、删除数据、修改权限、公开发布或处理受监管信息;单次错误也可能造成重大损失。
证据缺失、阈值失败或 Policy 不明确:保持当前生产版本,不允许绕过门禁。
离线证据通过但仍有生产不确定性:小流量、限时运行,持续监控并准备立即回滚。
质量、风险、业务验收和恢复方案全部通过:发布准确的 Model / Prompt / Index / Policy Version Bundle。
PROS, CONS & FAILURESAI Engineering System Design方案的优点、限制与故障处理
方案的优点与缺点
- 统一评分便于比较不同版本;但客服、招聘等场景的风险不同,不能只看一个平均分。
- 自动评分可以覆盖更多案例;但仍需要人工确认过的标准答案定期校准。
- 严格的发布检查可以降低事故概率;低风险内部实验则可以使用更轻量的流程。
常见故障及处理方法
- 模型只针对公开测试集优化:保留一部分从未参与开发的测试,并加入真实线上错误案例。
- 自动评分存在偏差:使用多个评分方式和人工抽查,并报告它们意见不一致的比例。
- 临时放宽规则后一直没有恢复:所有例外必须设置负责人和到期时间,到期后自动停止。
上线后要监控的指标
评测与线上服务分开运行;高风险 Agent 使用更多案例和更高评测频率。
高风险权限检查必须同步完成;复杂质量评测在后台运行,不阻塞普通回答。
记录测试案例、自动评分、安全测试、人工审核和事故处理的费用。
评测 Prompt 和来源同样视为不可信输入,只有必要人员可以访问评测数据。
在同一页面查看任务完成率、危害案例、安全问题、响应时间、费用和业务结果。
AI ENGINEER BOOTCAMP扫码或点击打开课程页面把 RAG、Agent、MCP、Memory 与 Governance 接成能上线的 Production Agentjiangren.com.au/program-course/ai-engineer-bootcamp查看课程 →
DESIGN REVIEWAI Engineering System Design设计评审需要回答的问题
需要回答的问题
- Task success 与 model accuracy 有什么区别?
- LLM-as-judge 如何校准?
- 哪些 failure 必须阻止发布?
- Production incident 如何进入 regression set?
提交设计前的检查清单
- 系统有 owner 和 risk tier。
- 评测覆盖 end-to-end outcome。
- 报告 failure slice。
- 例外有 expiry。
- 事故可触发 rollback 和新测试。
PRIMARY SOURCESAI Engineering System Design官方文档与论文
- NIST · AI Risk Management Framework
https://www.nist.gov/itl/ai-risk-management-framework - NIST · Privacy Framework
https://www.nist.gov/privacy-framework - OpenAI · Agents guide
https://platform.openai.com/docs/guides/agents - OpenAI · Tools guide
https://platform.openai.com/docs/guides/tools - OpenAI · Evals guide
https://platform.openai.com/docs/guides/evals - OpenAI · Realtime API guide
https://platform.openai.com/docs/guides/realtime - OpenAI · Deep research API guide
https://developers.openai.com/api/docs/guides/deep-research - OpenAI · Codex documentation
https://developers.openai.com/codex/ - Anthropic · Claude Code overview
https://docs.anthropic.com/en/docs/claude-code/overview - Anthropic · Claude Code security
https://docs.anthropic.com/en/docs/claude-code/security - Anthropic · Effective context engineering for AI agents
https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents - Google Cloud · Generative AI with RAG reference architectures
https://docs.cloud.google.com/architecture/rag-reference-architectures - Lewis et al. · Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
https://arxiv.org/abs/2005.11401
PRIMARY SOURCESAI Engineering System Design官方文档与论文(续)
- Microsoft · GraphRAG indexing dataflow
https://microsoft.github.io/graphrag/index/default_dataflow/ - Microsoft · GraphRAG query engine
https://microsoft.github.io/graphrag/query/overview/ - LangChain · Add and manage memory
https://docs.langchain.com/oss/python/langgraph/add-memory - LangChain · Durable execution
https://docs.langchain.com/oss/python/langgraph/durable-execution - Temporal · Temporal Workflows
https://docs.temporal.io/workflows - Model Context Protocol · MCP Authorization specification
https://modelcontextprotocol.io/specification/2025-06-18/basic/authorization - OWASP · Agentic Security Initiative
https://genai.owasp.org/initiatives/agentic-security-initiative/ - Microsoft Azure · Generative AI gateway capabilities
https://learn.microsoft.com/en-us/azure/api-management/genai-gateway-capabilities - vLLM · vLLM online serving
https://docs.vllm.ai/en/latest/serving/online_serving/ - Kubernetes · Schedule GPUs
https://kubernetes.io/docs/tasks/manage-gpus/scheduling-gpus/ - Google Cloud · Document AI overview
https://cloud.google.com/document-ai/docs/overview - OpenTelemetry · Generative AI semantic conventions
https://opentelemetry.io/docs/specs/semconv/gen-ai/ - OpenSSF · SLSA specification
https://slsa.dev/spec/v1.2/